Was ist GPT Image 2? OpenAIs leistungsfähigstes Bildmodell erklärt
GPT Image 2 ist OpenAIs neuestes und leistungsfähigstes Bildgenerierungsmodell, das am 21. April 2026 unter dem offiziellen API-Namen `gpt-image-2` veröffentlicht wurde. Auch als ChatGPT Images 2.0 vermarktet, ist es der direkte Nachfolger von GPT Image 1.5 (Dezember 2025) und stellt den bisher bedeutendsten Fortschritt in der GPT Image-Familie dar.
Die entscheidende Neuerung ist nicht nur die Bildqualität, sondern das Reasoning. GPT Image 2 ist das erste OpenAI-Bildmodell mit nativen „Thinking"-Fähigkeiten: Es kann die Komposition planen, im Web suchen, seine Ausgaben selbst überprüfen und bis zu acht kohärente Bilder aus einem einzigen Prompt mit konsistenten Figuren und Objekten generieren. OpenAI beschreibt es nicht als kreatives Spielzeug, sondern als „visuellen Denkpartner" für produktionsreife Workflows.
Veröffentlichungsdatum und Verfügbarkeit
OpenAI kündigte GPT Image 2 am 21. April 2026 an und veröffentlichte es gleichzeitig. Alle ChatGPT- und Codex-Nutzer erhielten am nächsten Tag, dem 22. April, Zugang. Die API (Modell-ID: `gpt-image-2`, Snapshot: `gpt-image-2-2026-04-21`) wurde kurz nach dem Launch für Entwickler verfügbar.
Die Veröffentlichung fällt mit der geplanten Einstellung von DALL-E 2 und DALL-E 3 am 12. Mai 2026 zusammen, was die GPT Image-Familie —und insbesondere GPT Image 2— zur einzigen Bildgenerierungsplattform von OpenAI macht.
Kernfähigkeiten
GPT Image 2 bringt eine Reihe von Fähigkeiten mit, die es von allen früheren OpenAI-Bildmodellen unterscheiden. Hier ist, was es kategorisch anders macht.
1. Natives Reasoning (Thinking-Modus)
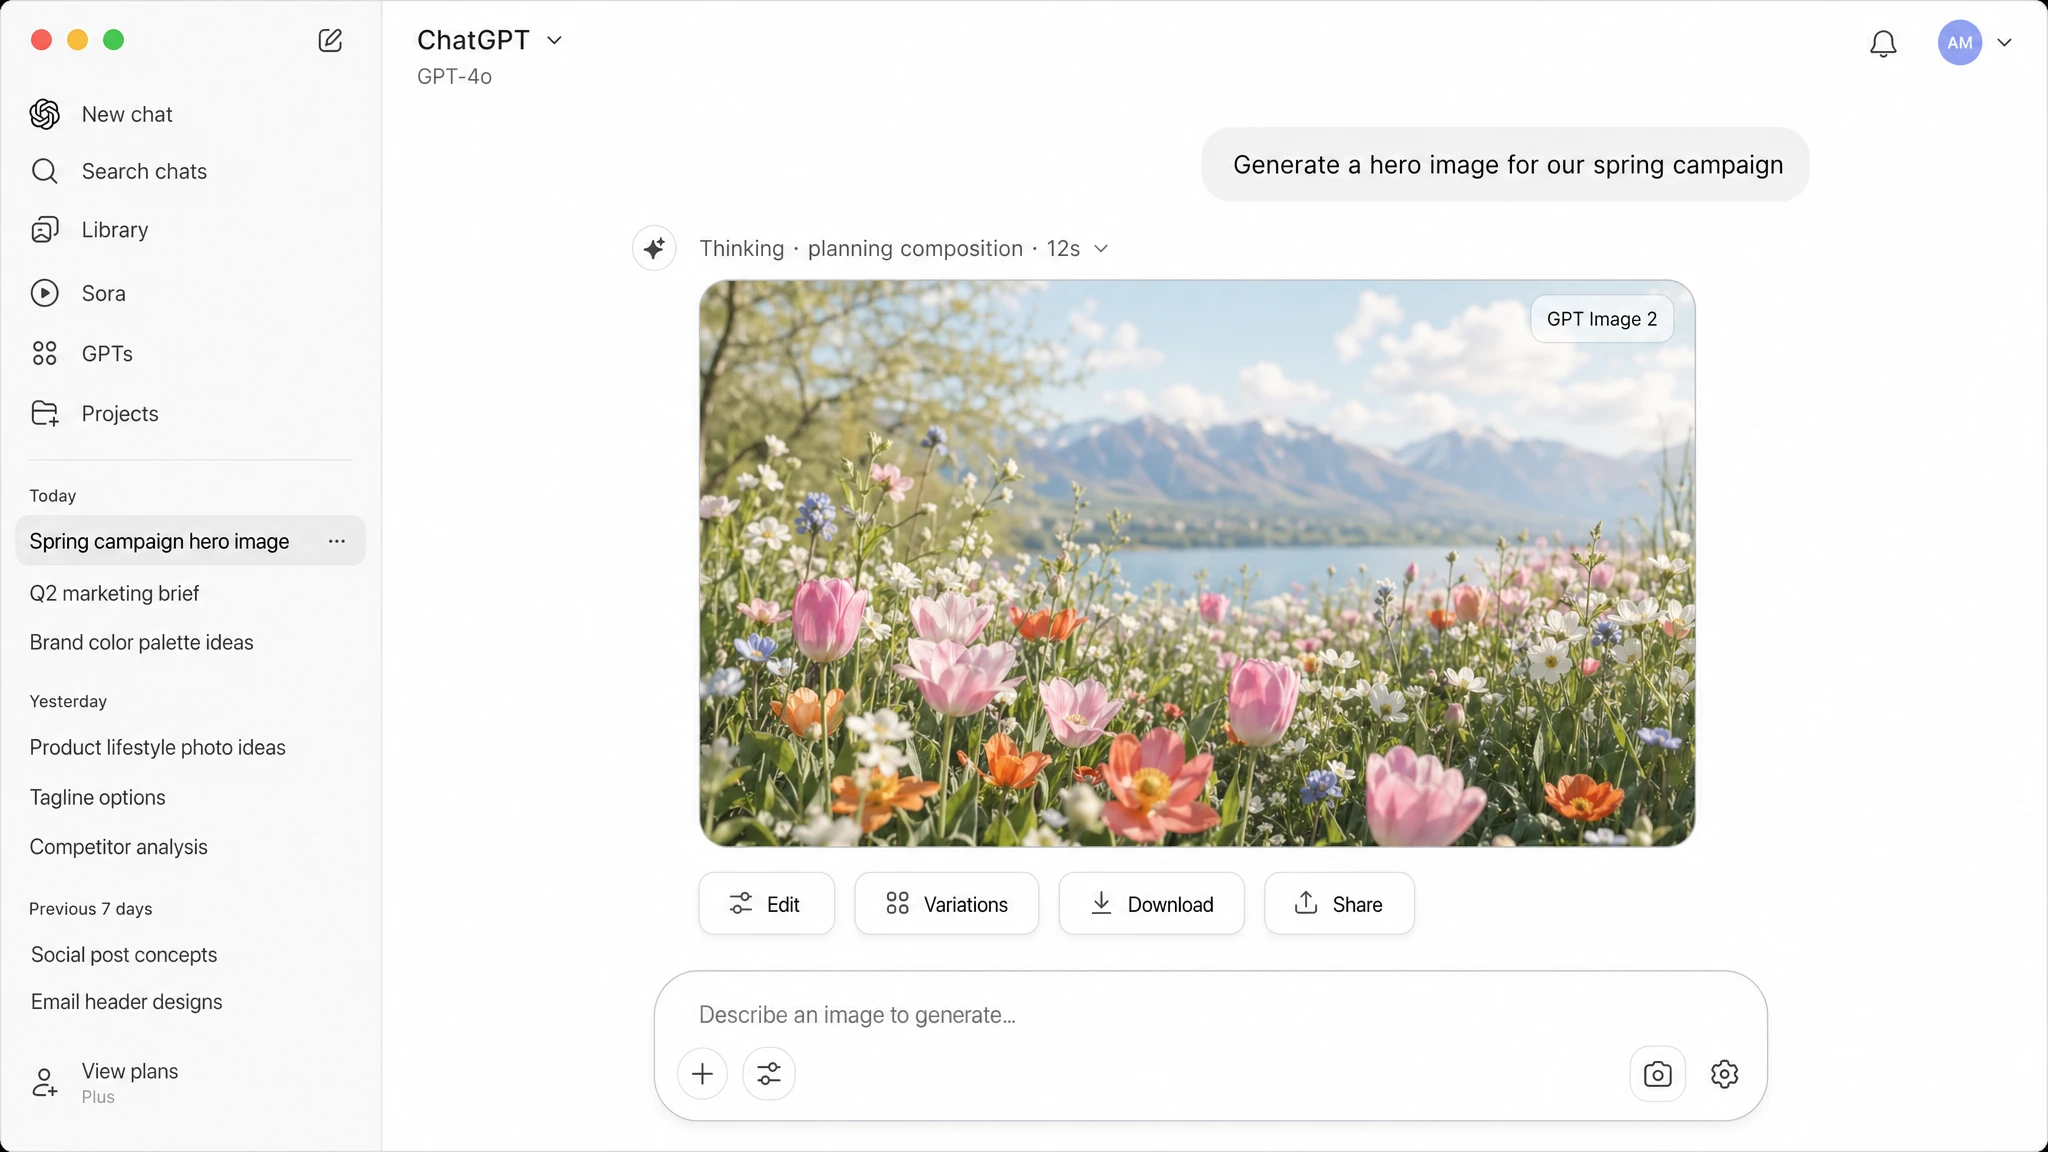
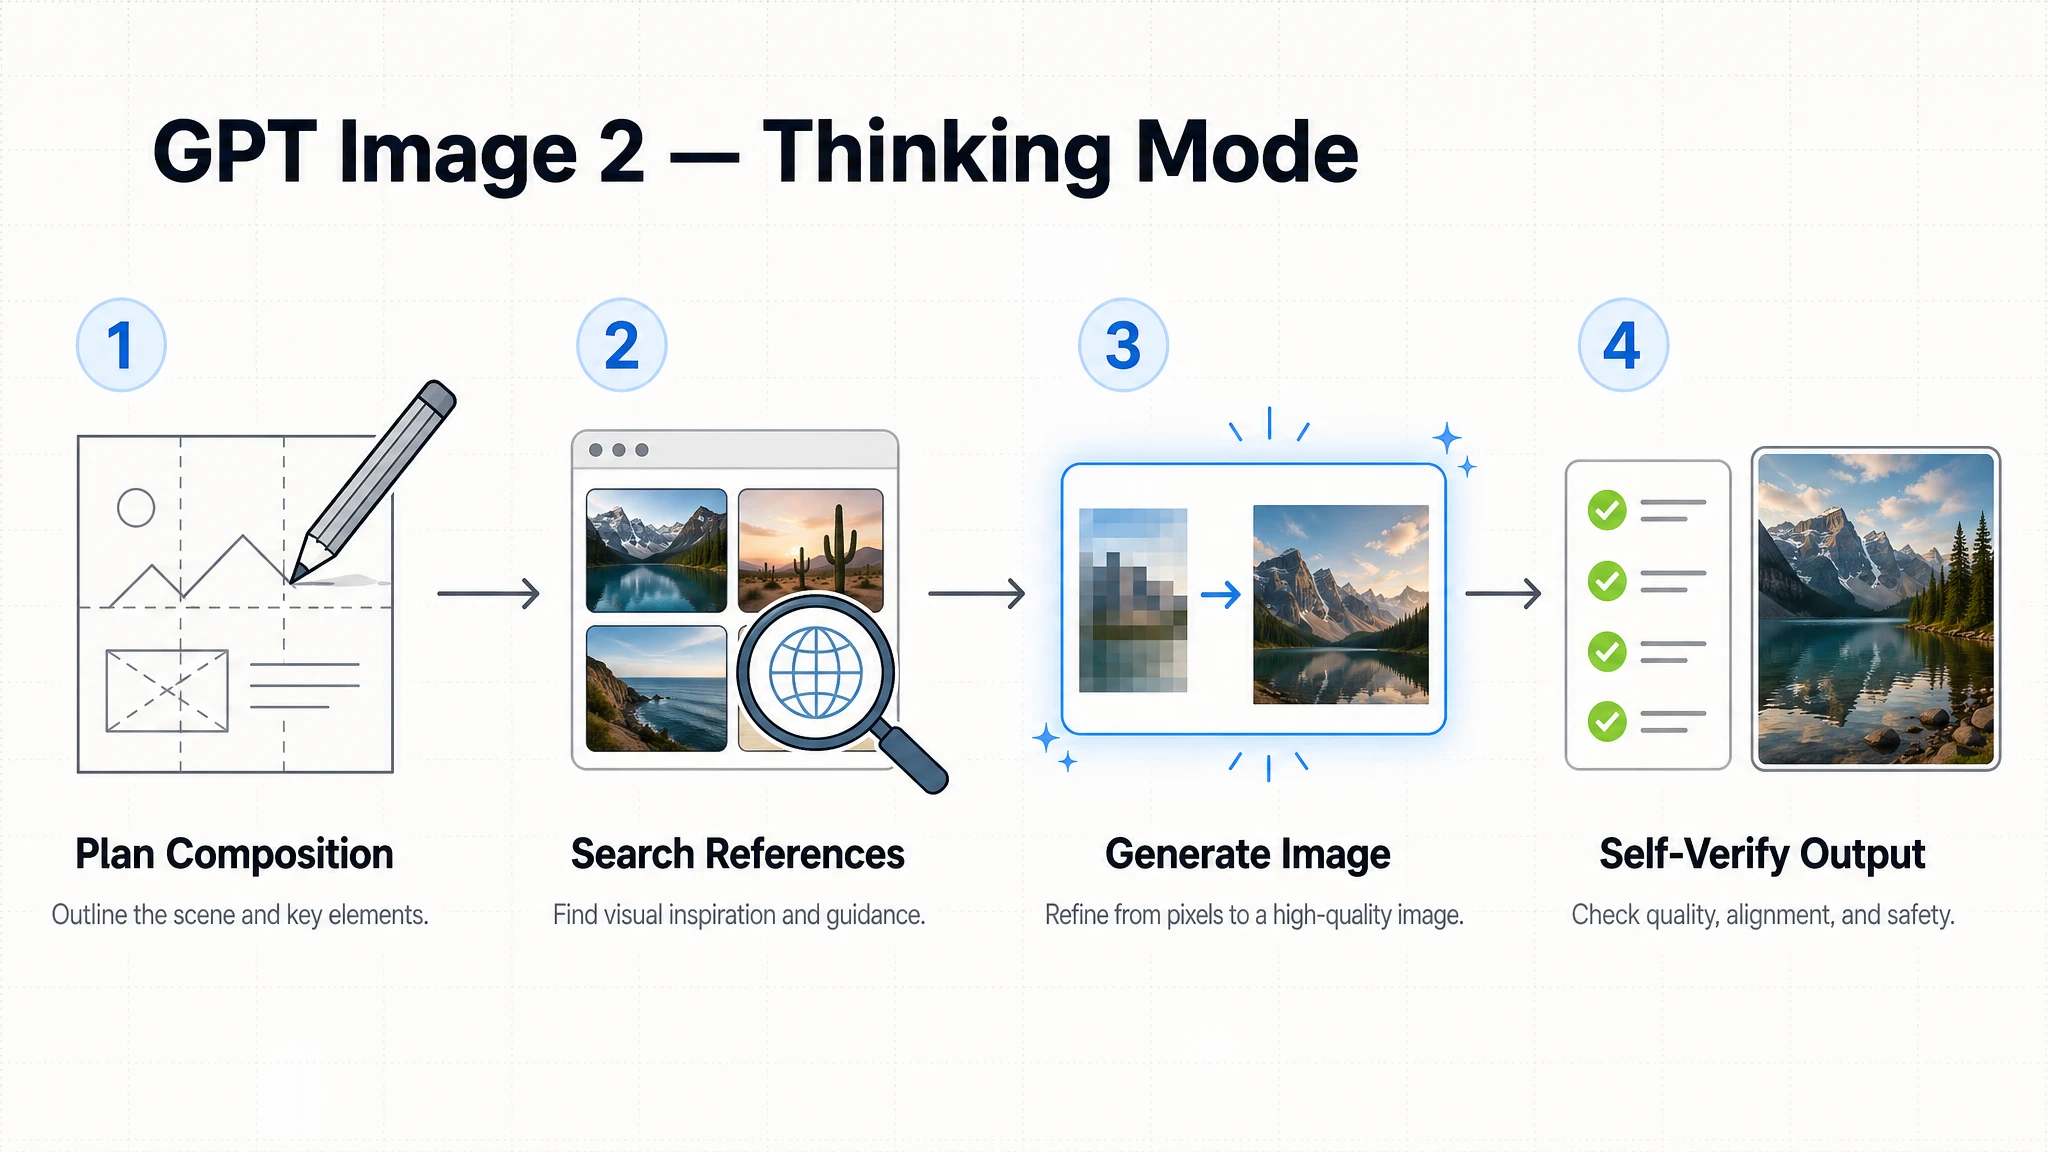
Das transformativste Merkmal von GPT Image 2 ist seine native Reasoning-Schicht. Im Thinking-Modus springt das Modell nicht direkt zur Pixelgenerierung — es plant zuerst die Komposition, denkt über das Layout nach und kann das Web nach echten visuellen Referenzen durchsuchen, bevor es ein Bild erzeugt. Nach der Generierung führt es eine Selbstprüfung durch, um zu validieren, dass die Ausgabe der ursprünglichen Absicht entspricht.
Dadurch unterscheidet sich GPT Image 2 grundlegend von allen diffusionsbasierten Vorgängern. Bei komplexen Prompts —ein mehrseitiger Comic, eine detaillierte Infografik, ein markenkonformes Marketingmaterial in fünf Seitenverhältnissen— erhöht der Thinking-Modus die Erstversuchserfolgsrate dramatisch.
Der Thinking-Modus ist auf zahlende ChatGPT-Abonnenten beschränkt (Plus für 20 $/Monat, Pro für 200 $/Monat, Business und Enterprise). Der Instant-Modus, der die Kernqualitätsverbesserungen bietet, steht allen Nutzern einschließlich des kostenlosen Tarifs zur Verfügung.
2. Textrendering
Das Rendern lesbaren Textes in generierten Bildern war historisch eine der größten Herausforderungen für KI-Modelle. GPT Image 2 erzielt eine entscheidende Verbesserung. OpenAI hebt ausdrücklich hervor, dass es mit „kleinem Text, Iconografie, UI-Elementen und dichten Kompositionen" umgehen kann — genau die Elemente, bei denen frühere Modelle systematisch scheiterten.
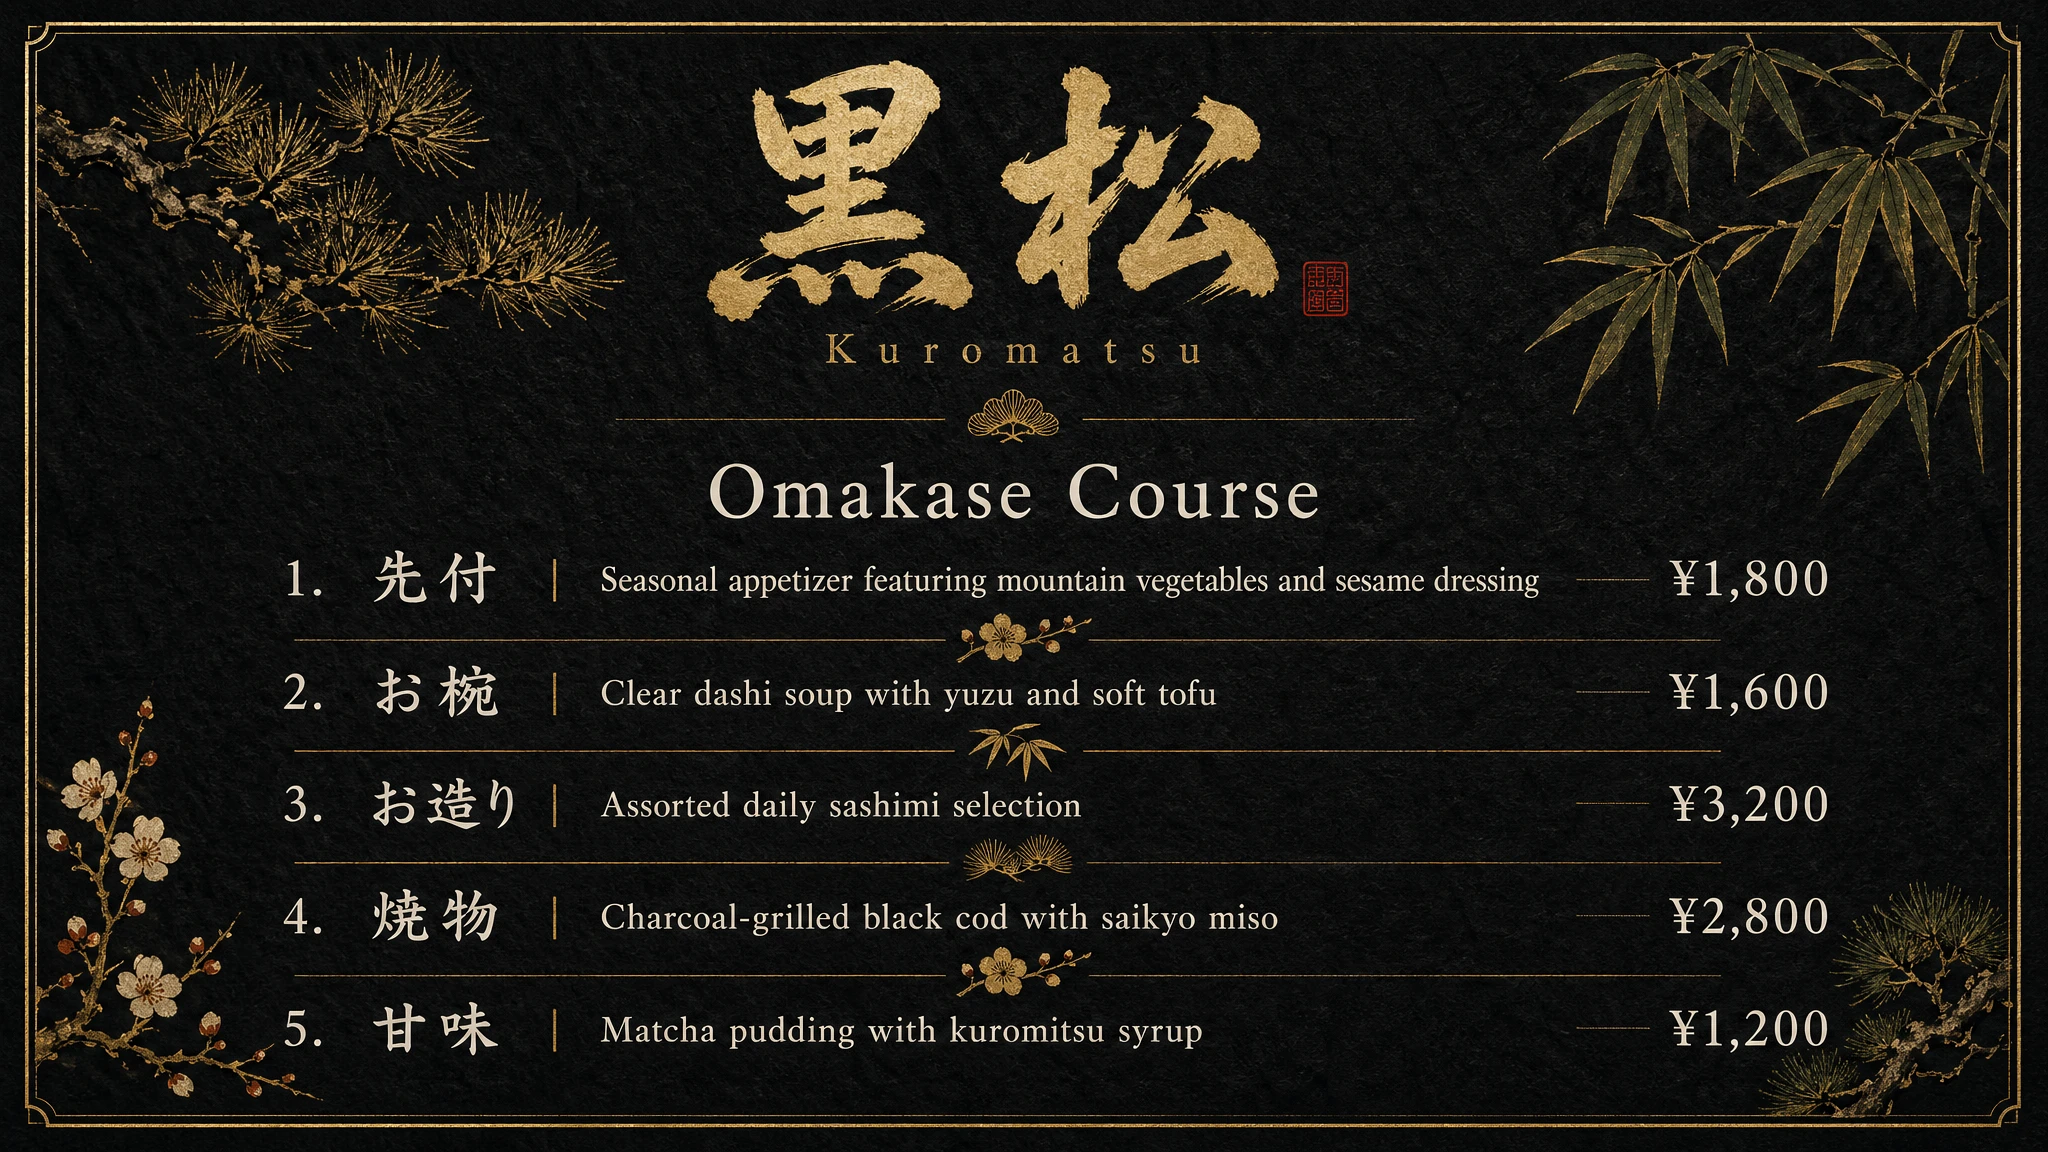
Bei lateinischen Schriften rendert das Modell Display-Schriftarten, Fließtext und stilisierte Typografie mit nahezu perfekter Genauigkeit in 2K-Auflösung. Bei nicht-lateinischen Schriften —Japanisch, Koreanisch, Chinesisch (CJK), Hindi und Bengali— erreicht es eine Zeichengenauigkeit, die frühere Modelle nicht bieten konnten. TechCrunch bemerkte, dass das Modell eine Restaurantkarte auf Spanisch erstellen kann, bei der „Kunden nicht merken würden, dass etwas nicht stimmt".
Dies hat direkte Auswirkungen für Marketingteams, Verlage, Spielestudios und E-Commerce-Marken, die zuvor manuelle Nachbearbeitung benötigten, um KI-generierten Text zu korrigieren.
Prompt
A premium Japanese restaurant menu printed on dark washi paper. The restaurant name "黒松" (Kuromatsu) appears at the top in large calligraphic brushstroke lettering. Below it, a clean section titled "Omakase Course" lists five dishes with Japanese names on the left and English descriptions on the right — each with a price in yen on the far right. Small illustrated botanical motifs separate each section. A thin gold border frames the entire menu. Typography is elegant and legible. All text must be fully accurate.
3. 2K-Auflösung und flexible Seitenverhältnisse
GPT Image 2 unterstützt nativ Auflösungen bis zu 2K (2048 px). Anders als GPT Image 1 und 1.5, die auf einen festen Satz von Größen beschränkt waren, akzeptiert GPT Image 2 jede Auflösung, die seine Dimensionsbeschränkungen erfüllt, wobei quadratische Bilder am schnellsten generiert werden.
Die Seitenverhältnisunterstützung reicht von 3:1 (kinematografisch ultrabreit) bis 1:3 (ultrahoch Hochformat), und deckt alle realen Produktionsformate ab: Social-Media-Posts, Plakatwandmockups, redaktionelle Layouts, Mobile-App-Screens und mehr. Dies eliminiert den Hochskalierungsschritt, der die Qualität in professionellen Workflows beeinträchtigte.
Eine konkrete Demonstration: Ein Kampagnenmaterial in einem einzigen Prompt generieren und es als Quadrat, 9:16 hochkant, 16:9 quer und 21:9 ultrabreit erhalten — alles in einem einzigen Batch mit identischer Komposition.
4. Mehrbild-Generierung mit Charakterkontinuität
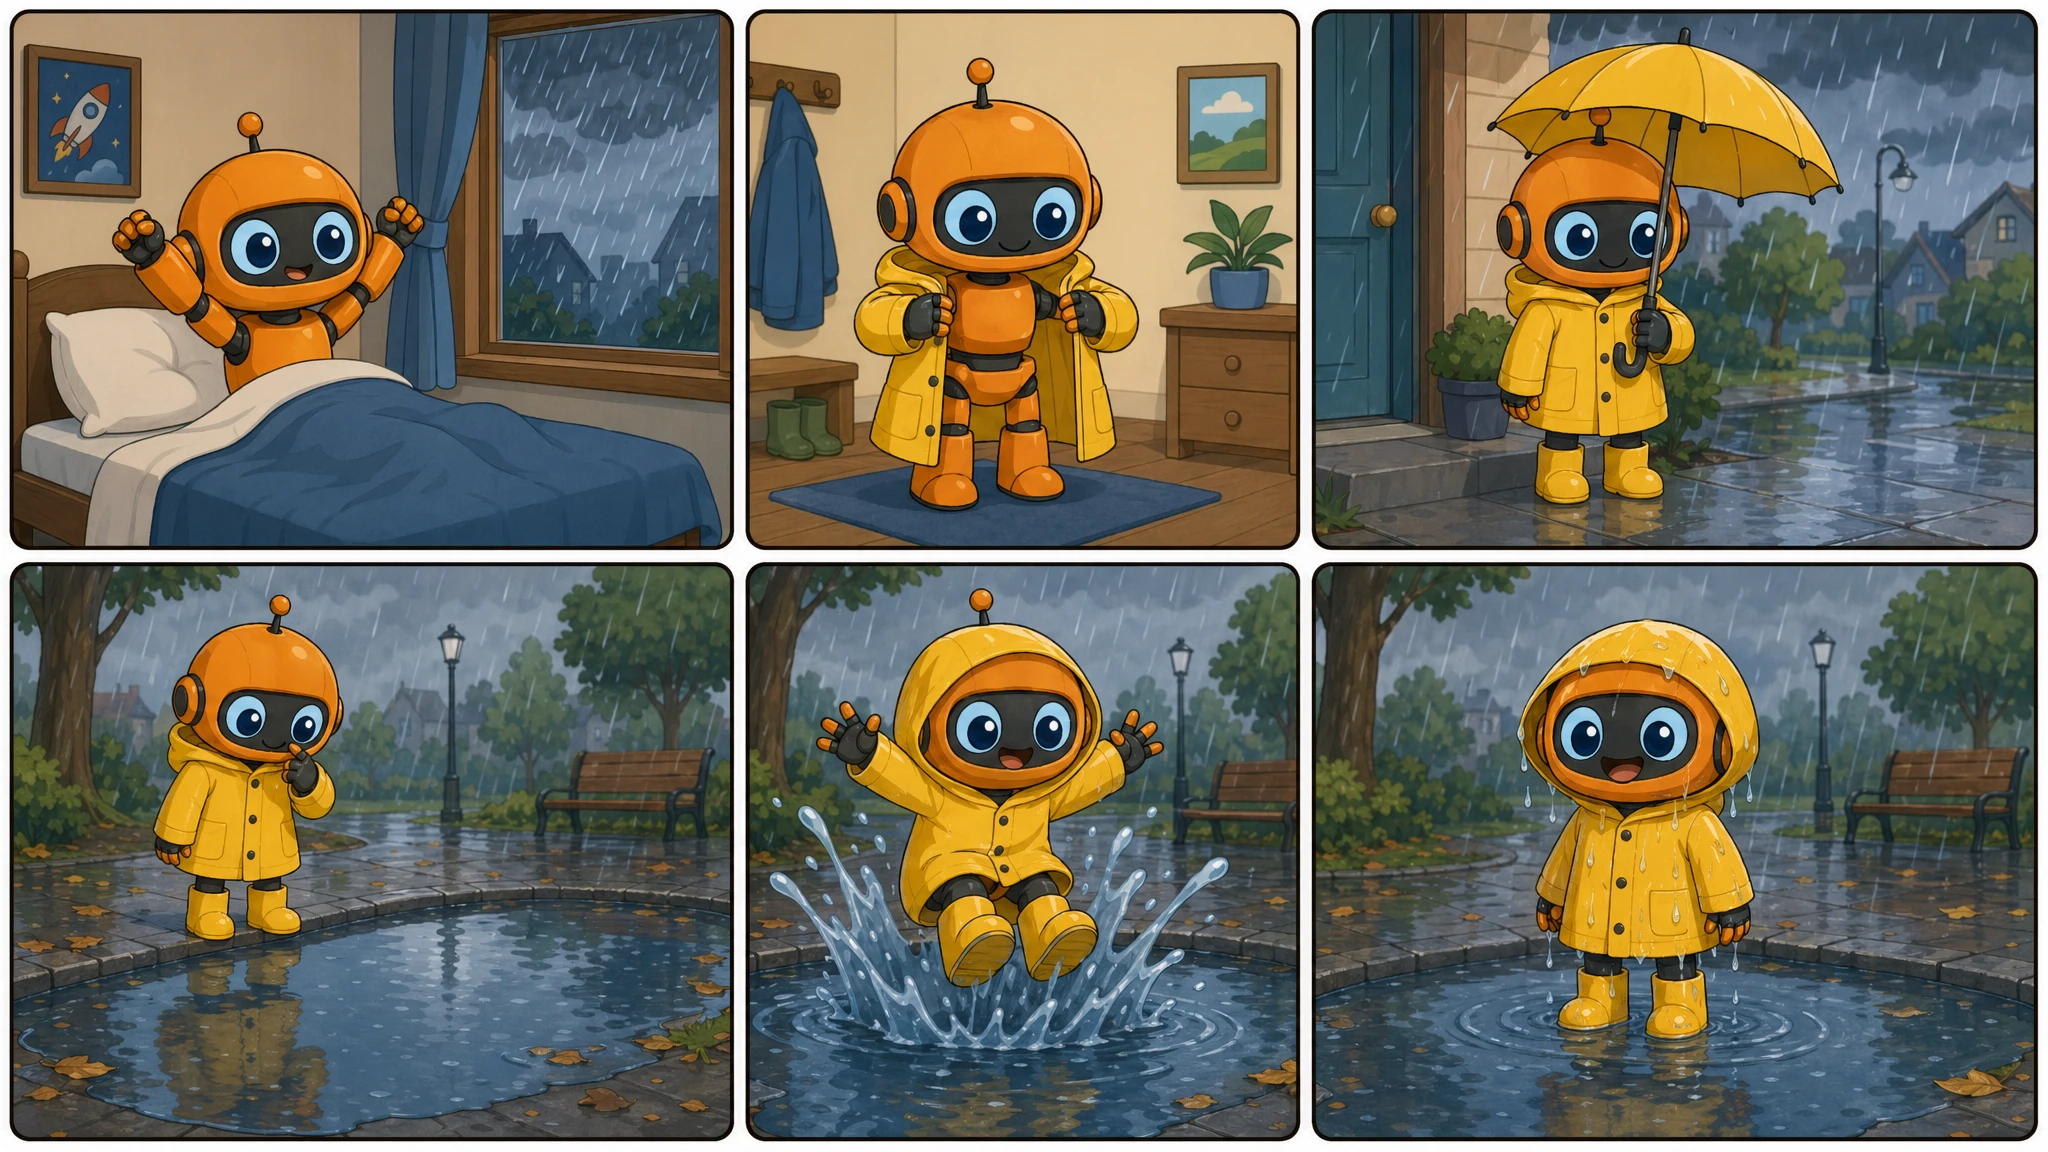
Im Thinking-Modus kann GPT Image 2 bis zu acht kohärente Bilder aus einem einzigen Prompt generieren und dabei die Charaktererscheinung, Objektanordnung und den visuellen Stil im gesamten Batch beibehalten. Dies ist ein neues Grundelement für Produktions-Workflows.
Anwendungsfälle, die nun in einer einzigen Generierung möglich sind: ein vollständiges Kinderbuch, eine Produktkampagne in mehreren Szenen, ein sechsseitiger Comic, ein Storyboard für eine Videoproduktion. Die Charakterkonsistenz wird durch die Reasoning-Schicht des Modells erzwungen, die Identitätsattribute —Erscheinung, Kleidung, Proportionen— über den gesamten Ausgabesatz verfolgt.
Über die Image API akzeptiert der Parameter `n` Werte von 1 bis 8.
Prompt
A six-panel comic strip in a clean flat-color illustration style. The main character is a small orange robot with a round head and large blue eyes. Panel 1: The robot wakes up and sees it is raining outside. Panel 2: It puts on a tiny yellow raincoat. Panel 3: It steps outside and opens a matching yellow umbrella. Panel 4: It spots a large puddle and hesitates. Panel 5: It jumps into the puddle with both feet. Panel 6: It stands in the puddle, soaking wet but smiling widely. Each panel has a thin rounded border. The robot must look identical in all six panels.
5. Web-Suchintegration
Wenn der Thinking-Modus aktiv ist, kann GPT Image 2 während des Generierungsprozesses das Web durchsuchen. Dies ist am nützlichsten für Prompts, die reale Subjekte betreffen: ein bestimmtes Gebäude, die visuelle Identität einer Marke, ein wissenschaftlich genaues Diagramm oder eine auf aktuellen Ereignissen basierende Illustration.
Anstatt eine plausible Annäherung zu erzeugen, ruft das Modell zuerst echte visuelle Referenzen ab und nutzt diese Informationen dann, um das generierte Bild in sachlicher Genauigkeit zu verankern. Bei Infografiken, Lehrdiagrammen und ortsspezifischen Szenen schließt dies die Lücke zwischen „sieht richtig aus" und „ist tatsächlich richtig".
Instant-Modus vs. Thinking-Modus
GPT Image 2 verfügt über zwei verschiedene Zugriffsmodi, die jeweils für verschiedene Anwendungsfälle und Abonnementstufen optimiert sind.
| Funktion | Instant-Modus | Thinking-Modus |
|---|---|---|
| Zugang | Alle Nutzer (einschl. kostenlos) | Plus, Pro, Business, Enterprise |
| Generierungsgeschwindigkeit | Schnell | Langsamer (Reasoning braucht Zeit) |
| Web-Suche während der Generierung | Nein | Ja |
| Mehrfach-Batch (bis zu 8 Bilder) | Nein | Ja |
| Charakterkontinuität im Batch | Nein | Ja |
| Selbstverifizierung der Ausgabe | Nein | Ja |
| Layout-Planung vor der Generierung | Nein | Ja |
| 2K-Auflösung | Ja | Ja |
| Verbessertes Textrendering | Ja | Ja |
| Mehrsprachiger Text | Ja | Ja |
Die Qualitätsverbesserungen von GPT Image 2 —Textrendering, 2K-Auflösung, mehrsprachige Unterstützung, Fotorealismus— sind in beiden Modi verfügbar. Der Thinking-Modus schaltet die agentische Schicht frei: Web-Suche, Mehrbild-Batch-Generierung mit Kontinuität und Selbstverifizierung. Für die einfache Einzelbild-Generierung ist der Instant-Modus ausreichend und schneller.
Was lässt sich mit GPT Image 2 erstellen?
OpenAI positionierte GPT Image 2 ausdrücklich als Produktionswerkzeug, nicht als kreatives Spielzeug. Die Launch-Ankündigung hob fünf Ausgabekategorien hervor, bei denen das Modell jeden früheren OpenAI-Bildmodell übertrifft:
- Marketingmaterialien: Kampagnenbilder, Social-Media-Grafiken und Produktmockups in mehreren Größen aus einem einzigen Prompt
- Infografiken und Diagramme: schrittweise visuelle Anleitungen, Datenvisualisierungen und Lehrdiagramme mit präzisen Textbeschriftungen
- UI-Mockups: App-Screens, Web-Interface-Wireframes und Design-System-Komponenten mit lesbaren UI-Elementen
- Comics und Storyboards: mehrseitige Erzählungen mit konsistenten Charakteren in allen Frames
- Folien und Präsentationen: Foliendecks mit korrekter Typografiehierarchie, Diagrammen und markenkonsistenten Visuals
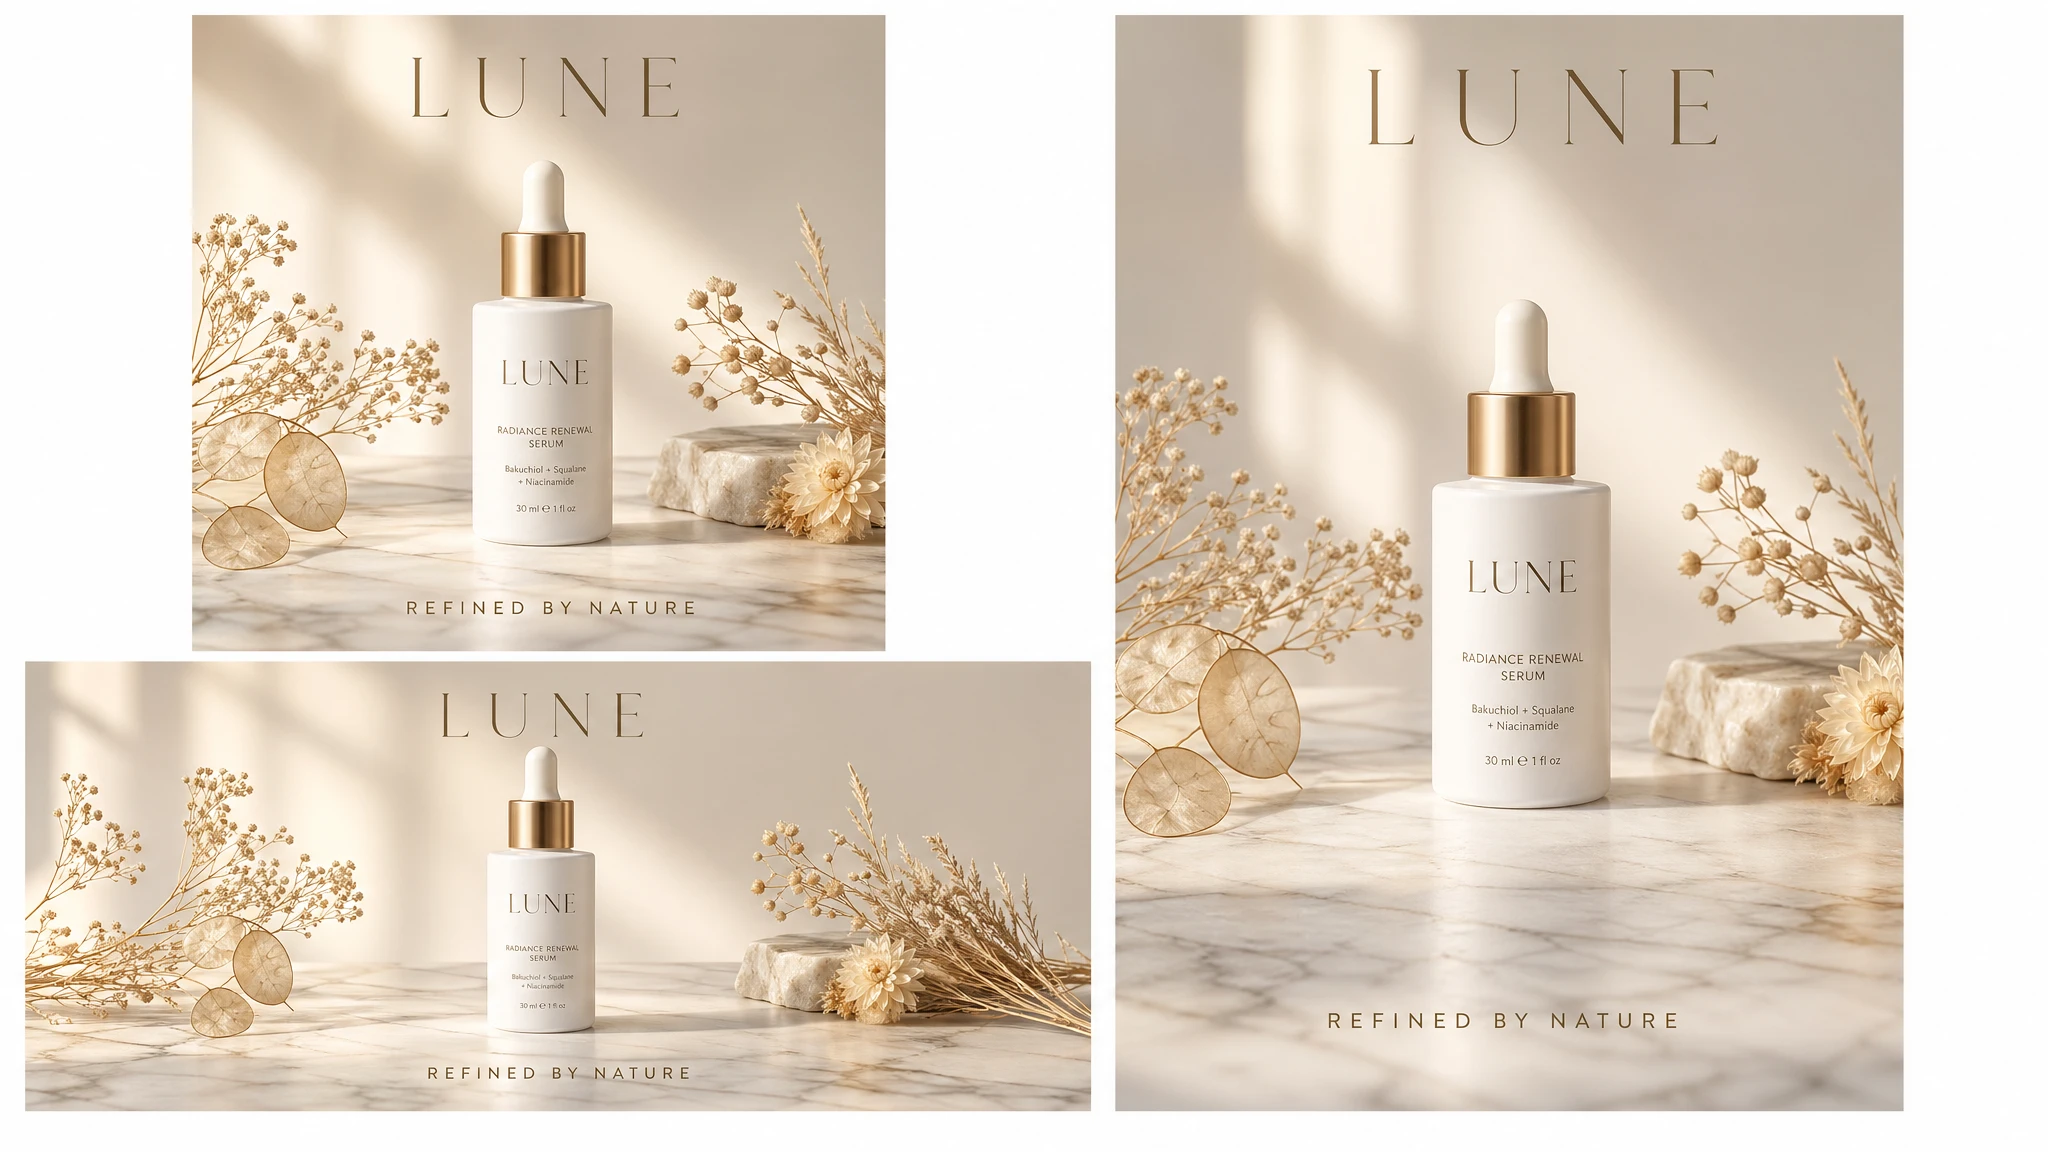
Prompt
A premium skincare product campaign for a brand called "LUNE." The hero visual shows a clean white serum bottle on a marble surface with soft golden-hour light, surrounded by dried botanicals. The brand name "LUNE" appears in a thin modern serif typeface at the top. A tagline "Refined by Nature" appears below the bottle in small caps. Generate this composition in three formats: 1:1 square, 16:9 landscape, and 4:5 portrait. Keep the product, lighting, text placement, and color palette identical across all three.
Technische Spezifikationen
| Spezifikation | Wert |
|---|---|
| API-Modell-ID | gpt-image-2 |
| Modell-Snapshot | gpt-image-2-2026-04-21 |
| Veröffentlichungsdatum | 21. April 2026 |
| Max. Auflösung | 2K (2048 px auf der längsten Seite) |
| Seitenverhältnisbereich | 3:1 (ultrabreit) bis 1:3 (ultrahoch) |
| Bilder pro Prompt (API) | 1 bis 8 (n-Parameter) |
| API-Endpunkte | v1/images/generations, v1/images/edits |
| Eingabetreue | Immer hohe Treue (nicht konfigurierbar) |
| Transparenter Hintergrund | Nicht unterstützt |
| Ausgabeformate | JPEG, WebP (Komprimierung 0–100%), PNG |
| Wissensschnitt | Dezember 2025 |
| C2PA-Metadaten | In allen Ausgaben enthalten |
Ein wichtiger technischer Hinweis: `gpt-image-2` verarbeitet jede Bildeingabe automatisch mit hoher Treue — der `input_fidelity`-Parameter, der in früheren Modellen existierte, wird nicht unterstützt und kann nicht geändert werden. Das bedeutet, dass Bearbeitungsanfragen mit Referenzbildern mehr Eingabe-Tokens verbrauchen, was bei der Kostenschätzung berücksichtigt werden sollte.
Wie sich GPT Image 2 mit früheren Modellen vergleicht
GPT Image 2 steht an der Spitze einer dreiGenerationen-API-Linie. DALL-E 3 war ein eigenständiges Diffusionsmodell, das als externes Werkzeug mit ChatGPT verbunden war. GPT Image 1 (April 2025) führte native multimodale Integration ein: besseres Instruktionsfolgen, Textrendering und Weltwissen. GPT Image 1.5 (Dezember 2025) fügte bilderhaltende Bearbeitung und schnellere Generierungszeiten hinzu.
GPT Image 2 baut auf GPT Image 1.5 mit einer grundlegend neuen Fähigkeitsschicht auf: nativem Reasoning. Das bringt allseitige Verbesserungen statt punktueller Anpassungen. Die folgende Tabelle fasst die generationellen Unterschiede zusammen.
| Funktion | DALL-E 3 | GPT Image 1 | GPT Image 1.5 | GPT Image 2 |
|---|---|---|---|---|
| Native multimodale Integration | Nein | Ja | Ja | Ja |
| Natives Reasoning / Thinking | Nein | Nein | Nein | Ja |
| Max. Auflösung | 1024px | 1536px | 1536px | 2048px (2K) |
| Mehrbild-Batch | Nein | Nein | Nein | Bis zu 8 |
| Web-Suche während Generierung | Nein | Nein | Nein | Ja (Thinking) |
| CJK / Hindi / Bengali Text | Schwach | Mäßig | Gut | Präzise |
| Bilderhaltende Bearbeitung | Nein | Nein | Ja | Ja |
| Ausgabe-Tokens pro 1M | — | $40 | $32 | $30 |
Aktuelle Einschränkungen
- Kein transparenter Hintergrund: Anfragen mit background: transparent geben für gpt-image-2 einen Fehler zurück, was das Generieren von ausgeschnittenen Assets ohne Nachbearbeitung verhindert.
- Wissensschnitt im Dezember 2025: Das Modell kann keine Visuals, die mit Ereignissen, Produkten oder Persönlichkeiten nach diesem Datum verknüpft sind, präzise generieren. Der Thinking-Modus kann durch Echtzeit-Web-Suche ergänzen, aber die visuelle Wissensbasis endet im Dezember 2025.
- Thinking-Modus nur für zahlende Nutzer: Die leistungsstärksten Funktionen —Mehrbild-Batch mit Kontinuität, Web-Suche und Selbstverifizierung— erfordern ein ChatGPT Plus-Abonnement (20 $/Monat) oder höher.
- Kein API-Zugang für kostenlose Konten: Über die API haben kostenlose Konten keinen Zugang zum Modell. Tier 1 beginnt mit 5 Bildern pro Minute (IPM).
- Hochwertige Generierung ist langsamer: Komplexe Prompts im Thinking-Modus können mehrere Minuten dauern. Dies ist ein bewusster Kompromiss für Genauigkeit, kein technischer Fehler.
Die Einschränkung bezüglich des transparenten Hintergrunds ist für Design- und E-Commerce-Workflows am einschneidendsten. Produktfotografie auf weißem Hintergrund, Logo-Generierung und Aufkleber-Asset-Erstellung erfordern transparente PNGs — derzeit unterstützen nur GPT Image 1, 1.5 und GPT Image 1 Mini dieses Ausgabeformat. OpenAI hat keinen Zeitplan für das Hinzufügen von transparentem Hintergrundunterstützung zu gpt-image-2 bekannt gegeben.
Sicherheit und Inhaltsrichtlinien
GPT Image 2 übernimmt die Sicherheitsinfrastruktur von GPT Image 1, einschließlich Standardschutzmaßnahmen gegen die Generierung schädlicher Bilder und obligatorisch in alle Ausgaben eingebetteten C2PA-Metadaten (Coalition for Content Provenance and Authenticity). Die C2PA-Metadaten ermöglichen eine maschinelle Überprüfung, dass GPT Image 2-Ausgaben KI-generierte Inhalte sind — relevant für Plattformen, die die Offenlegung von KI-Inhalten durchsetzen.
Entwickler, die über die API auf das Modell zugreifen, können die Moderationsempfindlichkeit über den Parameter `moderation` steuern: `auto` wendet die Standardfilterung an, während `low` die Filterung für weniger restriktive Anwendungen reduziert. Standardmäßig trainiert OpenAI nicht auf Kunden-API-Daten.
Zusammenfassung
GPT Image 2 ist ein generationeller Fortschritt für OpenAIs Bildgenerierungsplattform. Es ist kein schnelleres DALL-E — es ist ein Modell, das denkt, bevor es zeichnet, seine eigenen Ausgaben überprüft, das Web durchsucht wenn Genauigkeit erforderlich ist und ein Storyboard aus acht Bildern mit konsistenten Charakteren aus einem einzigen Prompt liefern kann.
Für Produktionsteams sind die bahnbrechenden Funktionen: Textrendering, das keine manuelle Korrektur mehr benötigt, native 2K-Auflösung, die externe Hochskalierung eliminiert, und Mehrbild-Batch-Generierung mit Kontinuität. Für gelegentliche Nutzer macht allein die Qualitätsverbesserung im Instant-Modus es zur leistungsstärksten Version der ChatGPT-Bildgenerierung.
| Eigenschaft | Wert |
|---|---|
| Offizieller Name | ChatGPT Images 2.0 / gpt-image-2 |
| Veröffentlicht | 21. April 2026 |
| Größte Neuerung | Natives Reasoning (Thinking-Modus) |
| Max. Auflösung | 2K (2048 px) |
| Max. Bilder pro Prompt | 8 (im Thinking-Modus) |
| Bestes Textrendering | Lateinisch, CJK, Hindi, Bengali, Arabisch |
| Transparenter Hintergrund | Nicht unterstützt |
| Wissensschnitt | Dezember 2025 |