GPT Image 2 en profundidad: 12 ejemplos reales para todos los casos de uso principales
GPT Image 2 — publicado también como ChatGPT Images 2.0 — se lanzó el 21 de abril de 2026. Es el primer modelo de generación de imágenes independiente de OpenAI: desacoplado del pipeline de GPT-4o, reconstruido con inferencia de un solo paso y el primer modelo de imagen en la línea de OpenAI con razonamiento nativo integrado en la arquitectura.
Las cifras clave: precisión de renderizado de texto del 99 %+, resolución nativa 2K (hasta 4K en formato apaisado), relaciones de aspecto de 3:1 ultra-ancho a 1:3 ultra-vertical y — con el modo Thinking — hasta ocho imágenes coherentes de un solo prompt con personajes consistentes en todo el lote.
Probamos 12 casos de uso relevantes para producción. Cada ejemplo a continuación fue generado con GPT Image 2 usando el prompt mostrado.
Qué cambió respecto a GPT Image 1.5
| Función | GPT Image 1.5 | GPT Image 2 |
|---|---|---|
| Arquitectura | Pipeline de imagen GPT-4o (dos etapas) | Modelo independiente, inferencia de un paso |
| Resolución máxima | 1536×1024 (apaisado) | 3840×2160 (4K apaisado) |
| Precisión de renderizado de texto | ~70 % (solo latino) | 99 %+, multilingüe |
| Integración de razonamiento | Ninguna | Modo Thinking nativo (con búsqueda web) |
| Lote de múltiples imágenes | No compatible | Hasta 8 imágenes por prompt (modo Thinking) |
| Edición en lenguaje natural | No compatible | Describe el cambio — sin máscara necesaria |
| Rango de relación de aspecto | 1:1 y presets fijos | 3:1 a 1:3, cualquier resolución dentro de restricciones |
| Cadena del modelo API | gpt-image-1.5 | gpt-image-2 |
GPT Image 2 no es una actualización de imagen de GPT-4o. Es una reconstrucción desde cero: metadatos diferentes en el PNG de salida, ruta de inferencia diferente y un pipeline de renderizado de texto completamente diferente. OpenAI lo posiciona como un 'compañero de pensamiento visual' construido para flujos de trabajo de producción, no para exploración creativa.
1. Retrato fotorrealista
Los retratos siguen siendo el punto de referencia más exigente para la generación de imágenes: la textura de la piel, la dispersión subsuperficial, la profundidad de campo y la proporción facial deben ser correctas al mismo tiempo. GPT Image 2 los maneja con lo que la documentación del propio modelo llama renderizado 'sensible a la identidad': los detalles finos se mantienen en todo el encuadre, no solo en el recorte central.
En nuestra prueba, solicitamos un retrato de primer plano con características específicas de iluminación y lente. Sin postprocesamiento, sin upscaling — salida directa del modelo en alta calidad, 1024×1024.
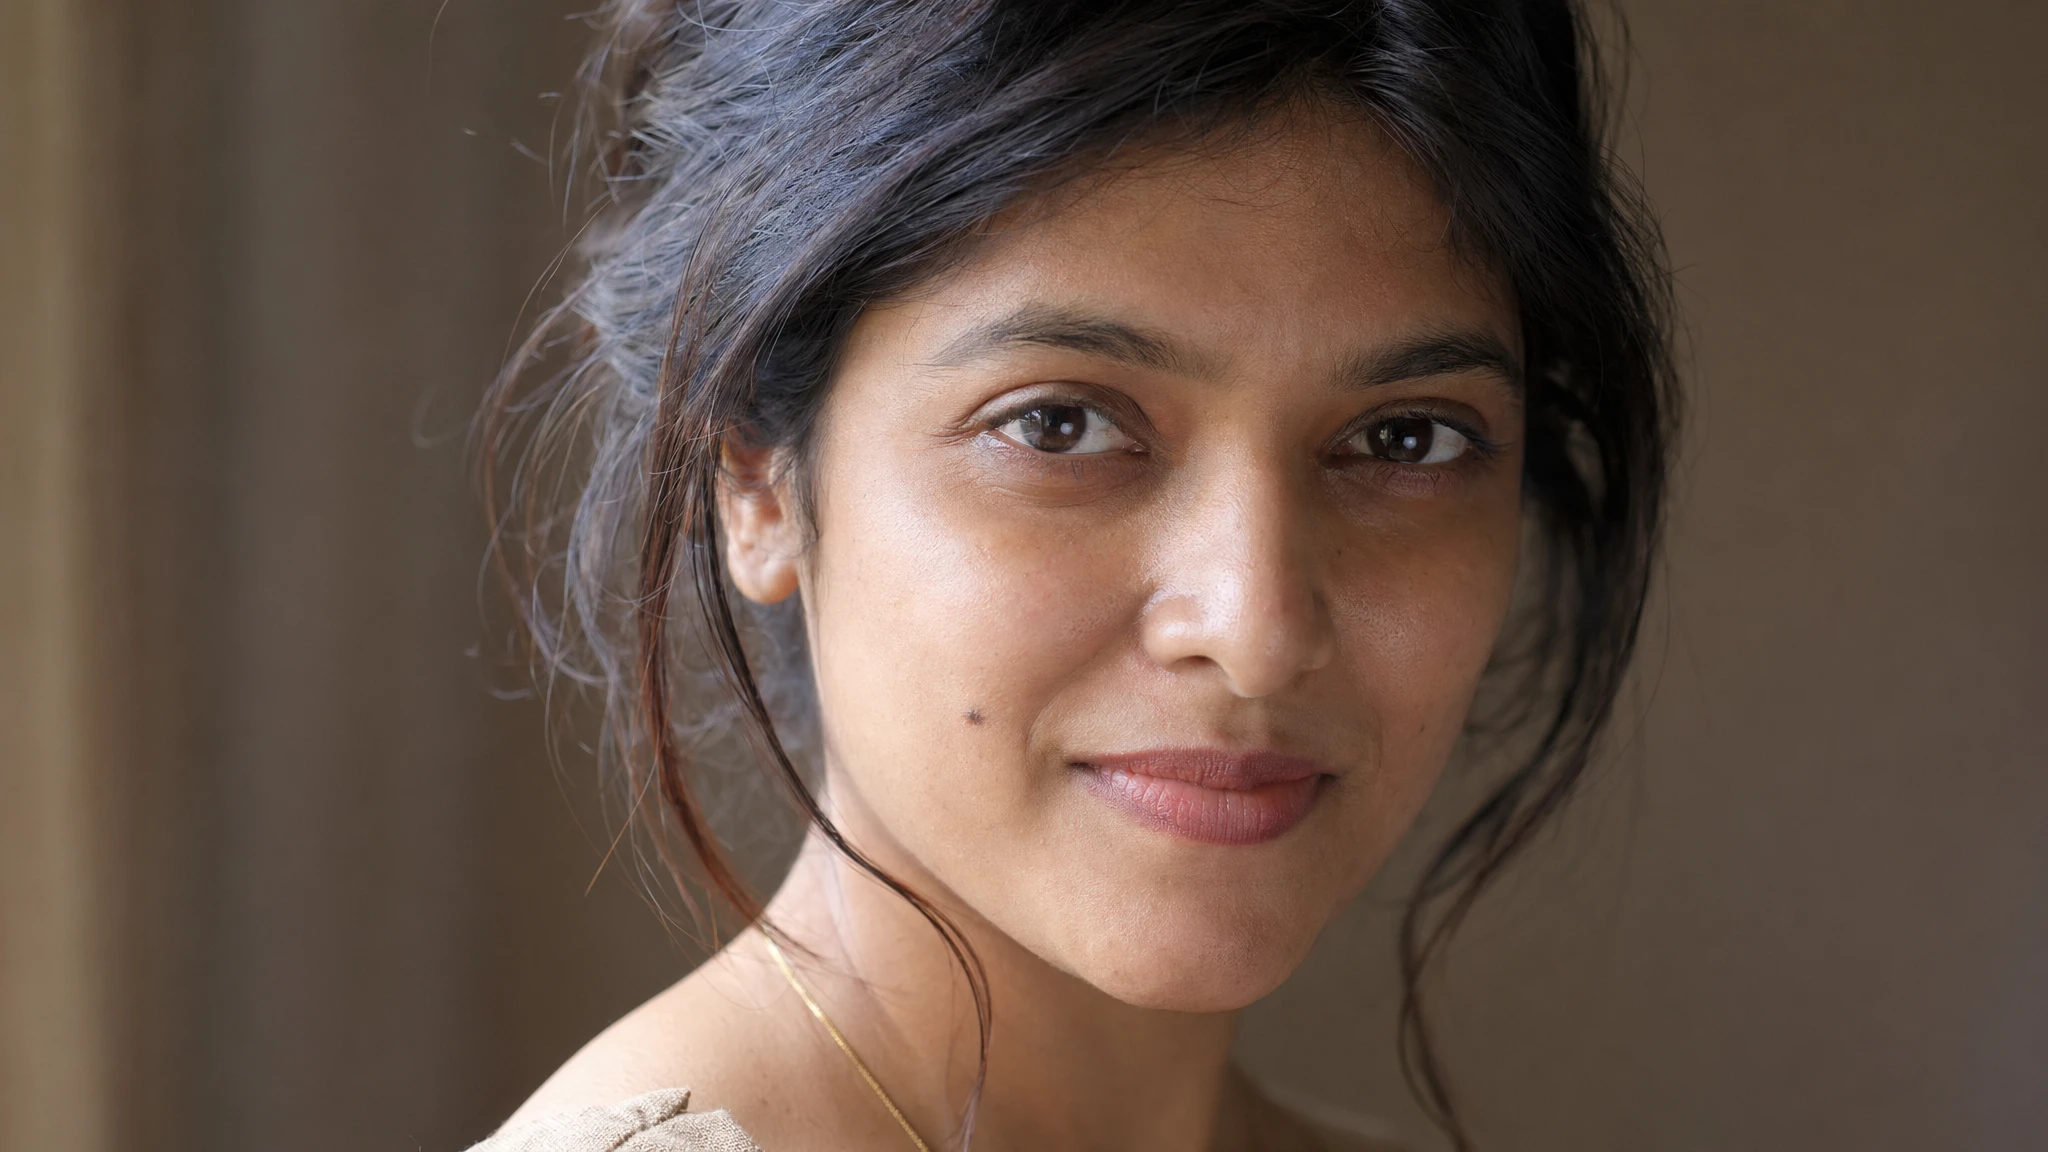
Prompt
A photorealistic close-up portrait of a South Asian woman in her late 20s, soft diffused window light from the upper left, very shallow depth of field with background completely out of focus, warm neutral background, 85mm lens perspective. Ultra-fine skin texture — visible pores, subtle smile lines near the eyes, one small birthmark on the left cheek. Dark brown eyes, natural makeup. Hair loosely pinned, a few strands falling forward. Shot on a medium format digital camera. No filters. No color grading.
Resultado: La textura de la piel se renderiza a nivel de poro. La dirección de la iluminación es físicamente consistente — relleno de sombra en el lado derecho, luz de borde recorriendo la oreja — sin especificación de iluminación manual más allá de 'luz de ventana desde arriba a la izquierda'. El lunar y las líneas de sonrisa están presentes.
2. Renderizado de texto multilingüe
El renderizado de texto es la capacidad definitoria de GPT Image 2 y la mayor brecha entre él y todos los modelos competidores. OpenAI lo logró introduciendo una vía tipográfica que escribe glifos como formas vectoriales antes de rasterizarlas en la escena.
El resultado práctico: el texto en inglés, japonés, coreano, árabe, chino, turco y hebreo se renderiza correctamente en el primer intento en la gran mayoría de los casos.
Probamos un cartel de festival de música con texto mixto japonés-inglés — uno de los escenarios de renderizado de texto más difíciles.
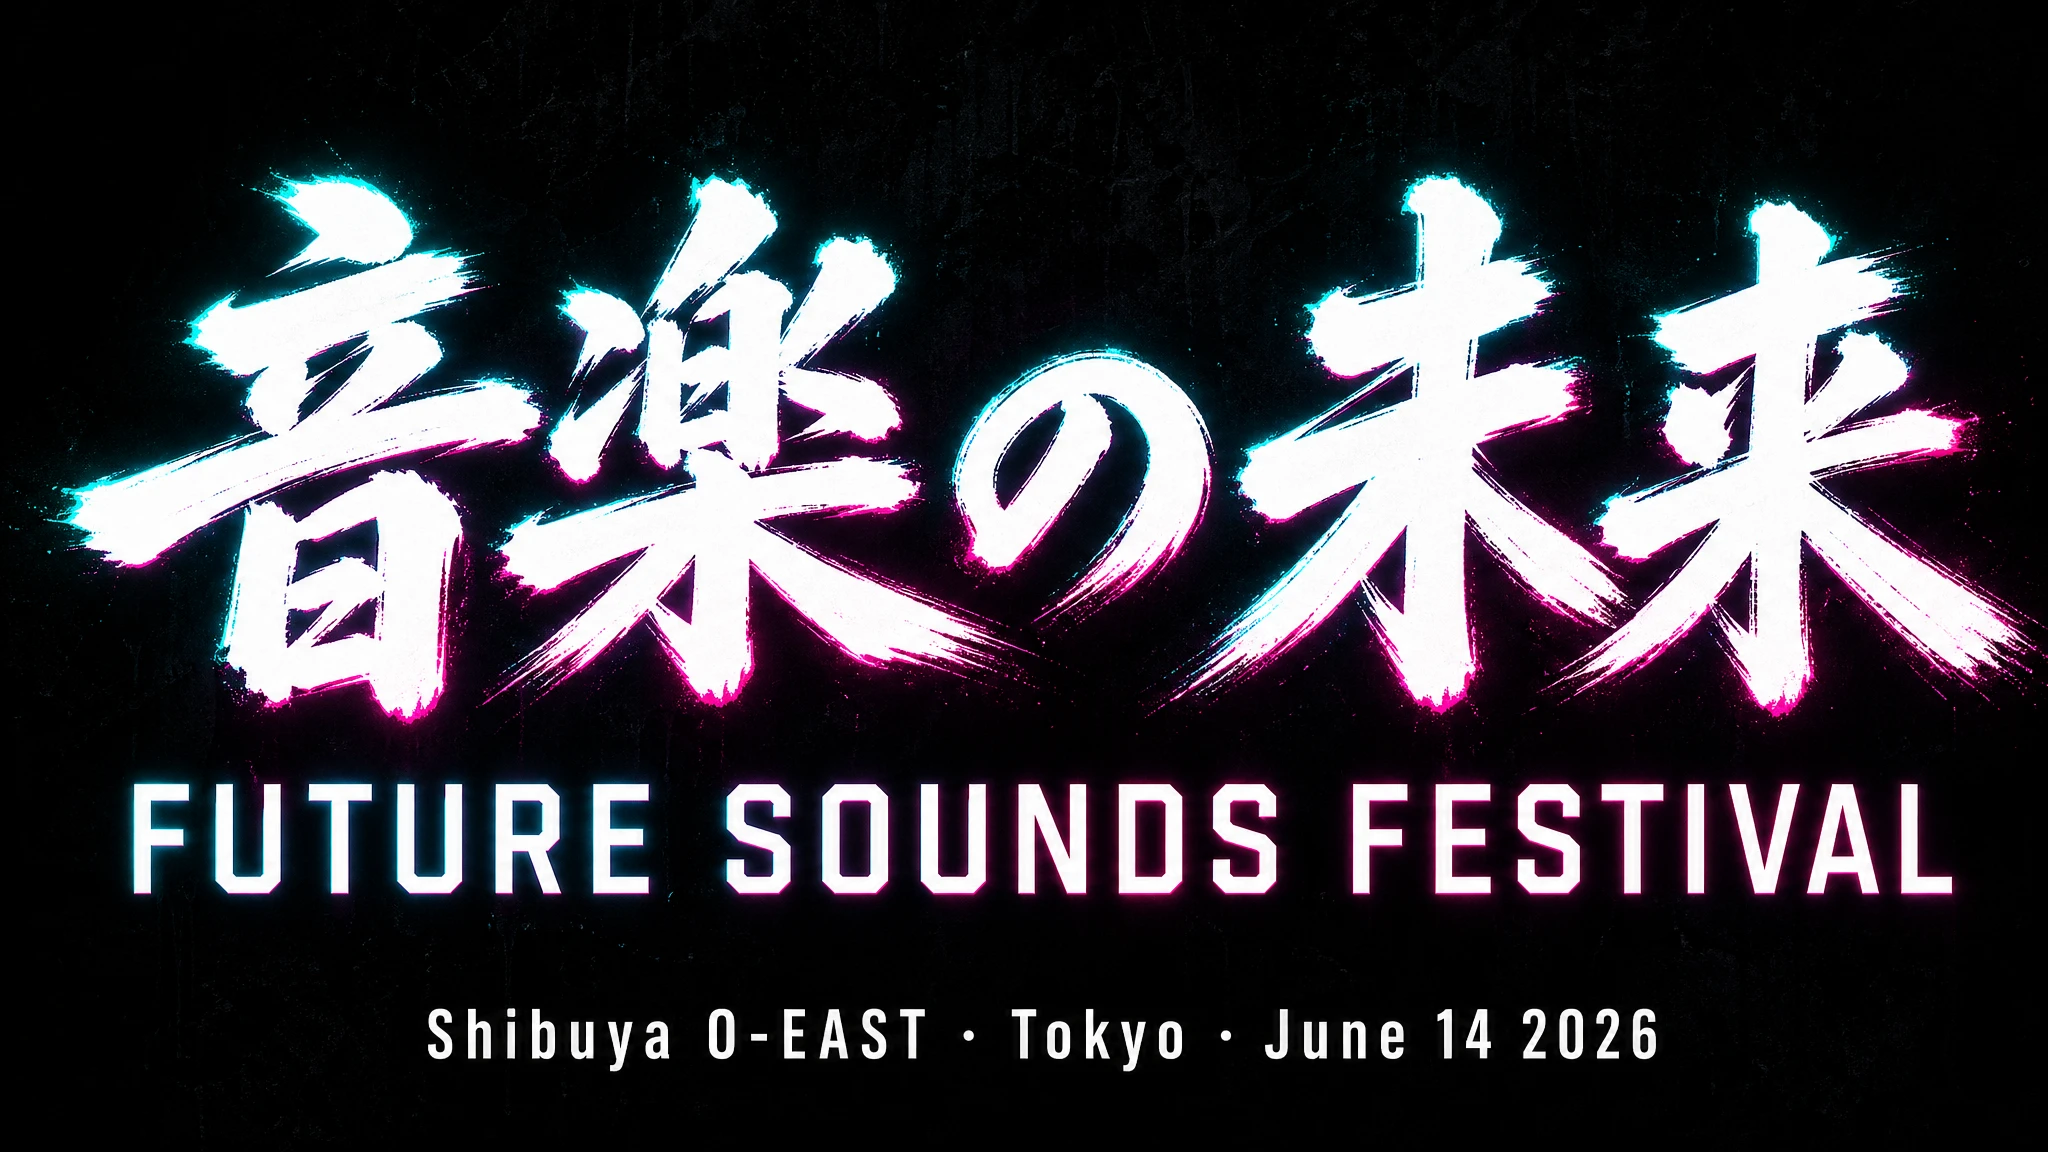
Prompt
A bold music festival poster. Headline: "音楽の未来" in large brushstroke kanji, centered at the top third. Directly below it in a clean geometric sans-serif: "FUTURE SOUNDS FESTIVAL". Venue and date in smaller white type at the bottom: "Shibuya O-EAST · Tokyo · June 14 2026". Dark background, electric teal and magenta neon glow. All text must be fully legible and correctly formed. No decorative elements that obscure the type.
Resultado: Todos los trazos de kanji están correctamente formados. El titular en inglés y la línea del local son completamente legibles. Limitación conocida: el árabe y el hebreo con diacríticos completos en tamaños de punto muy pequeños producen ocasionalmente errores de glifo individual.
3. Fotografía de producto
La fotografía de producto para e-commerce es uno de los casos de uso con mayor valor comercial para GPT Image 2. El modelo maneja reflexiones, sombras de superficie, texturas de materiales — vidrio, metal mate, papel kraft, cerámica — y profundidad de campo correcta.
Probamos un flat lay de skincare premium — una categoría de prompt de referencia porque requiere resaltes especulares correctos en el vidrio, texto de etiqueta legible y colocación convincente de pétalos.
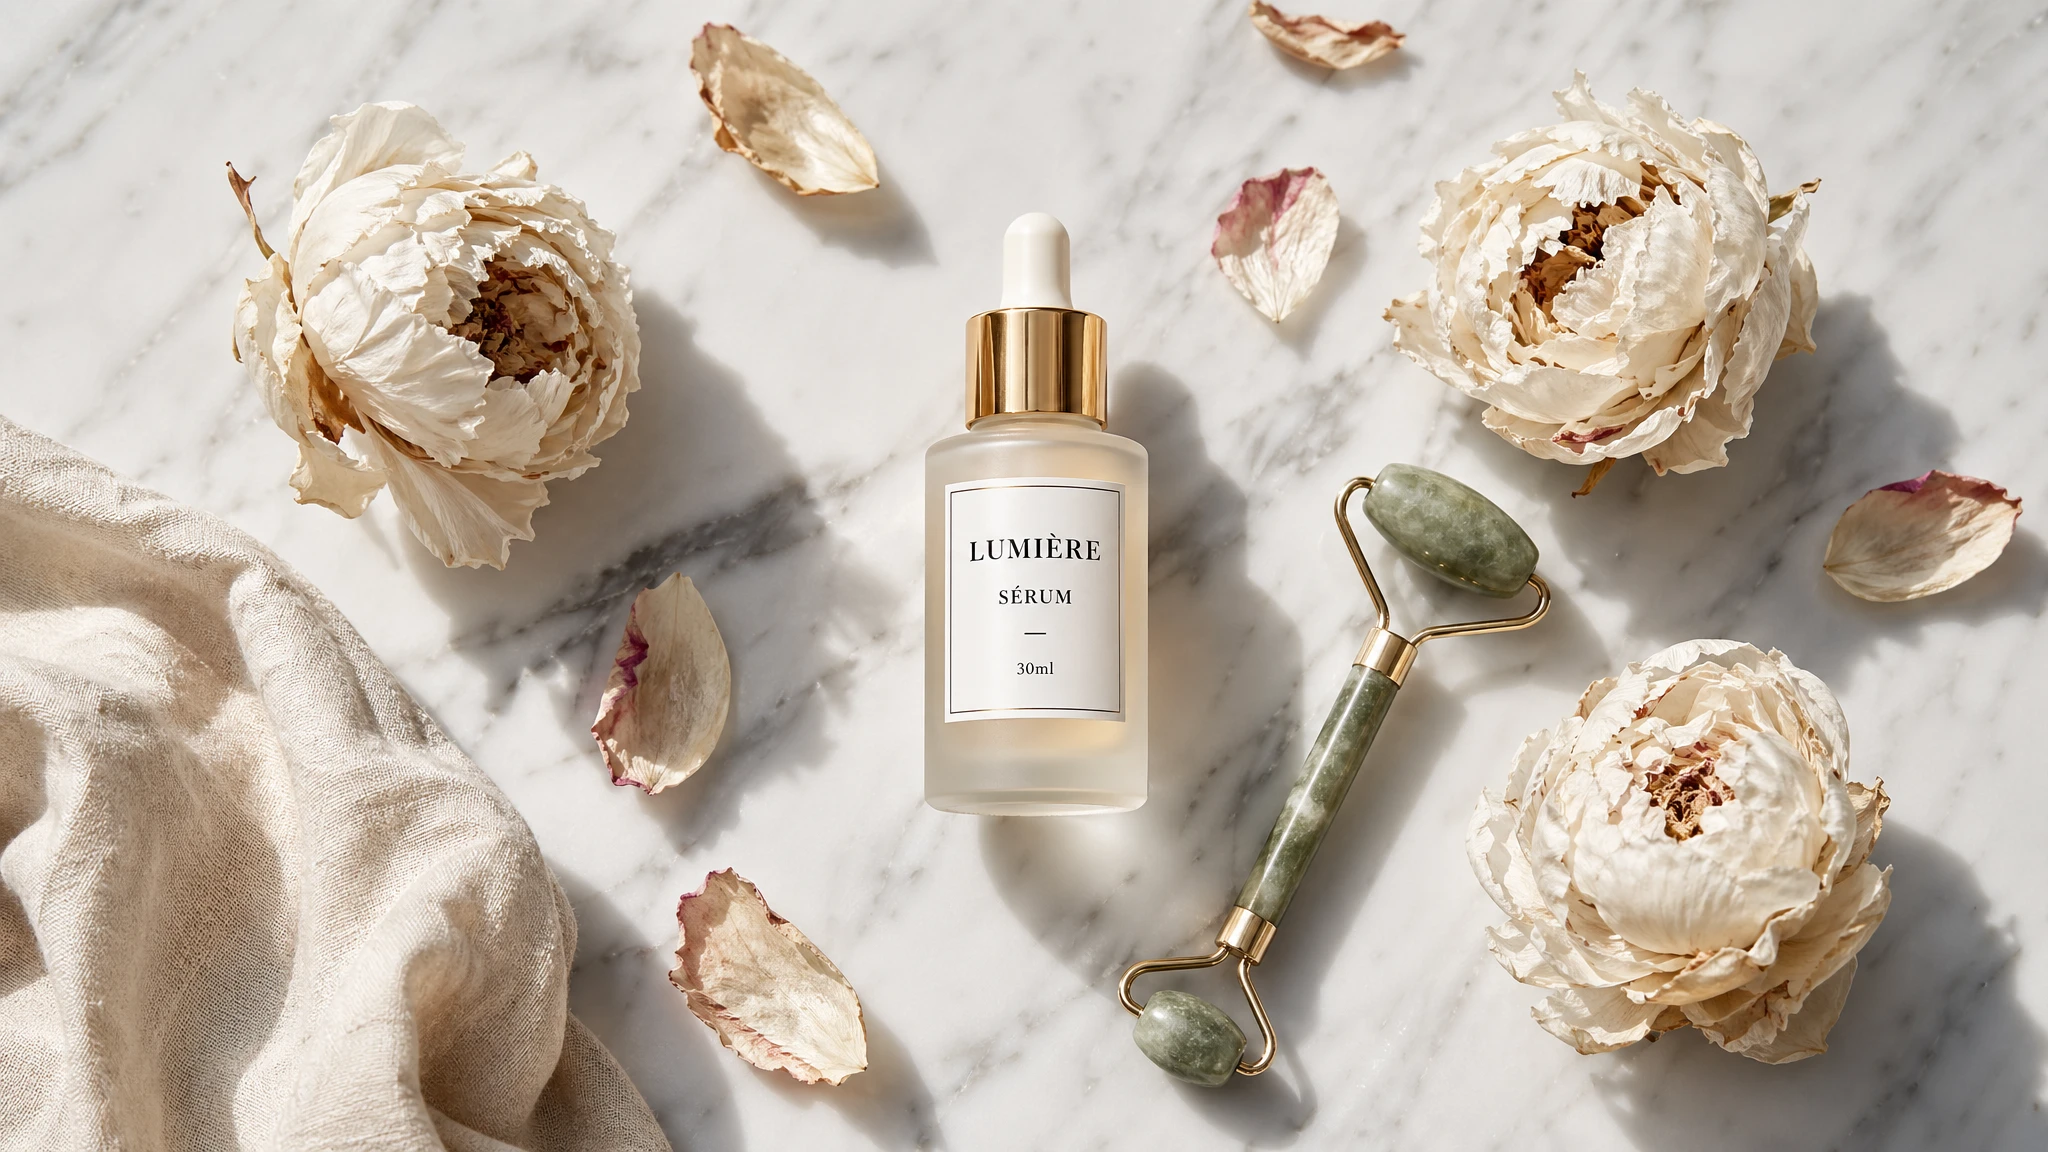
Prompt
A high-end skincare flat lay on a smooth white marble surface. Center: a frosted glass serum bottle with a gold dropper cap. The label reads "LUMIÈRE SÉRUM — 30ml" in clean black serif type. Surrounding it: three dried white peonies, scattered rose petals, a small jade facial roller, and a cream-colored linen cloth slightly crumpled in the bottom-left corner. Soft north window light from above-left. Clean drop shadow under each object. No artificial studio look — feels like a magazine editorial. Shot from directly above. 16:9 crop.
Resultado: El texto de la etiqueta 'LUMIÈRE SÉRUM — 30ml' se renderiza correctamente, incluida la É con acento. La textura del vidrio esmerilado y los destellos del tapón cuentagotas dorado son precisos. La colocación de los pétalos parece orgánica, no algorítmicamente regular.
4. Embalaje de producto con etiquetas legibles
Las maquetas de embalaje requieren la versión más difícil del renderizado de texto: listas de ingredientes, tablas nutricionales, texto legal y tipografía de marca, todo en una superficie tridimensional con distorsión curva y textura de material.
Antes de GPT Image 2, esto era imposible sin un compuesto de herramienta de diseño. GPT Image 2 es el primer modelo capaz de renderizar una maqueta de embalaje con texto correcto a lo largo — no solo el titular.
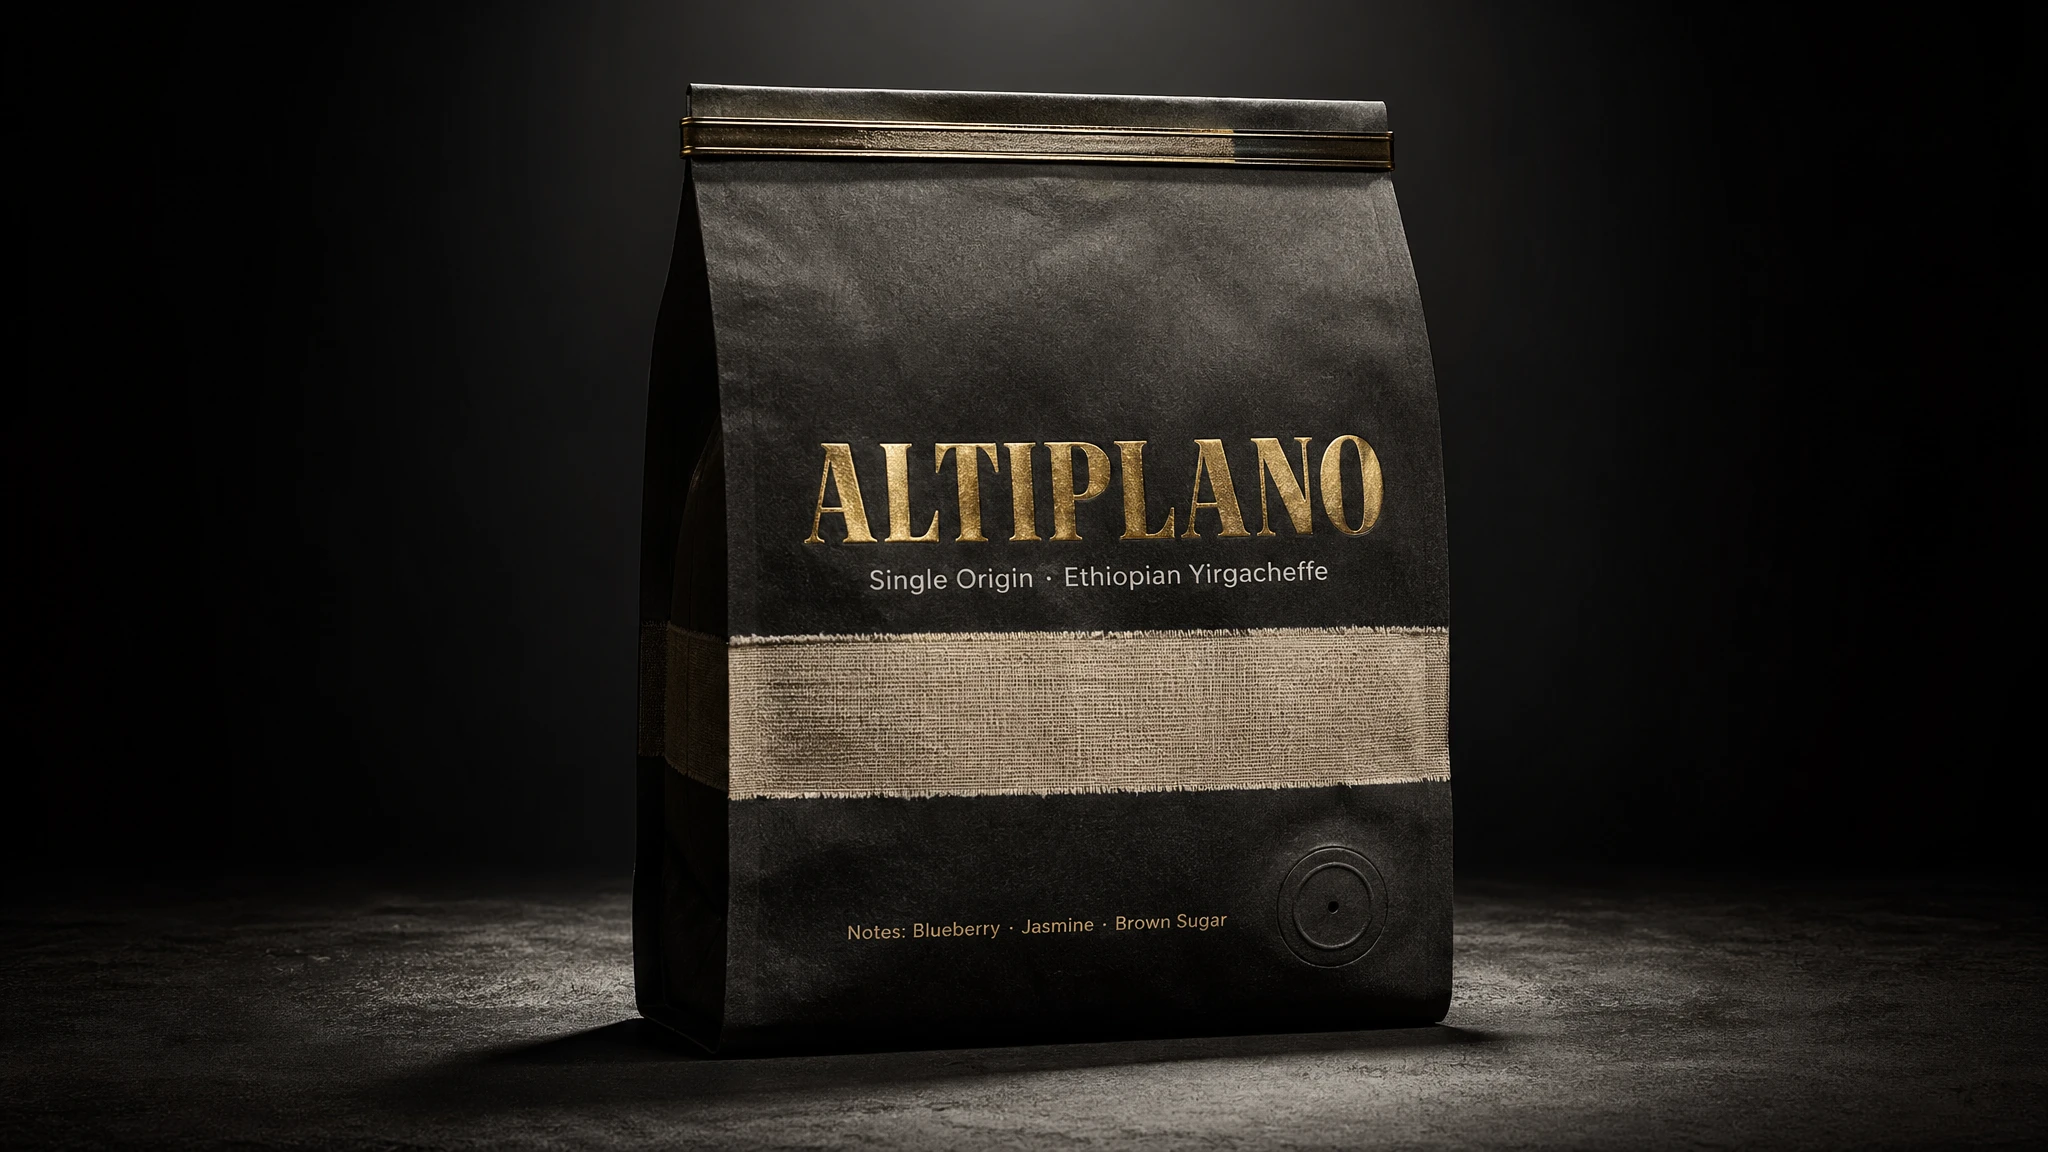
Prompt
A photorealistic standing coffee bag mockup. The bag is matte black kraft paper with a natural linen texture stripe across the center. Brand name on the front: "ALTIPLANO" in a bold, wide uppercase serif, letterpressed in gold foil. Below it: "Single Origin · Ethiopian Yirgacheffe" in a smaller clean sans-serif. Bottom strip: "Notes: Blueberry · Jasmine · Brown Sugar". The bag has a tin-tie closure at the top and a circular degassing valve on the lower right. Dark studio background with a single dramatic spotlight from above. Realistic paper texture, no plastic sheen.
Resultado: Todos los elementos de texto se renderizan correctamente, incluidos el subtítulo y las notas de cata. La textura del papel, el cierre de corbata de estaño y la válvula de desgasificación son físicamente plausibles. Directamente utilizable en un pitch deck o listado de e-commerce sin retoque.
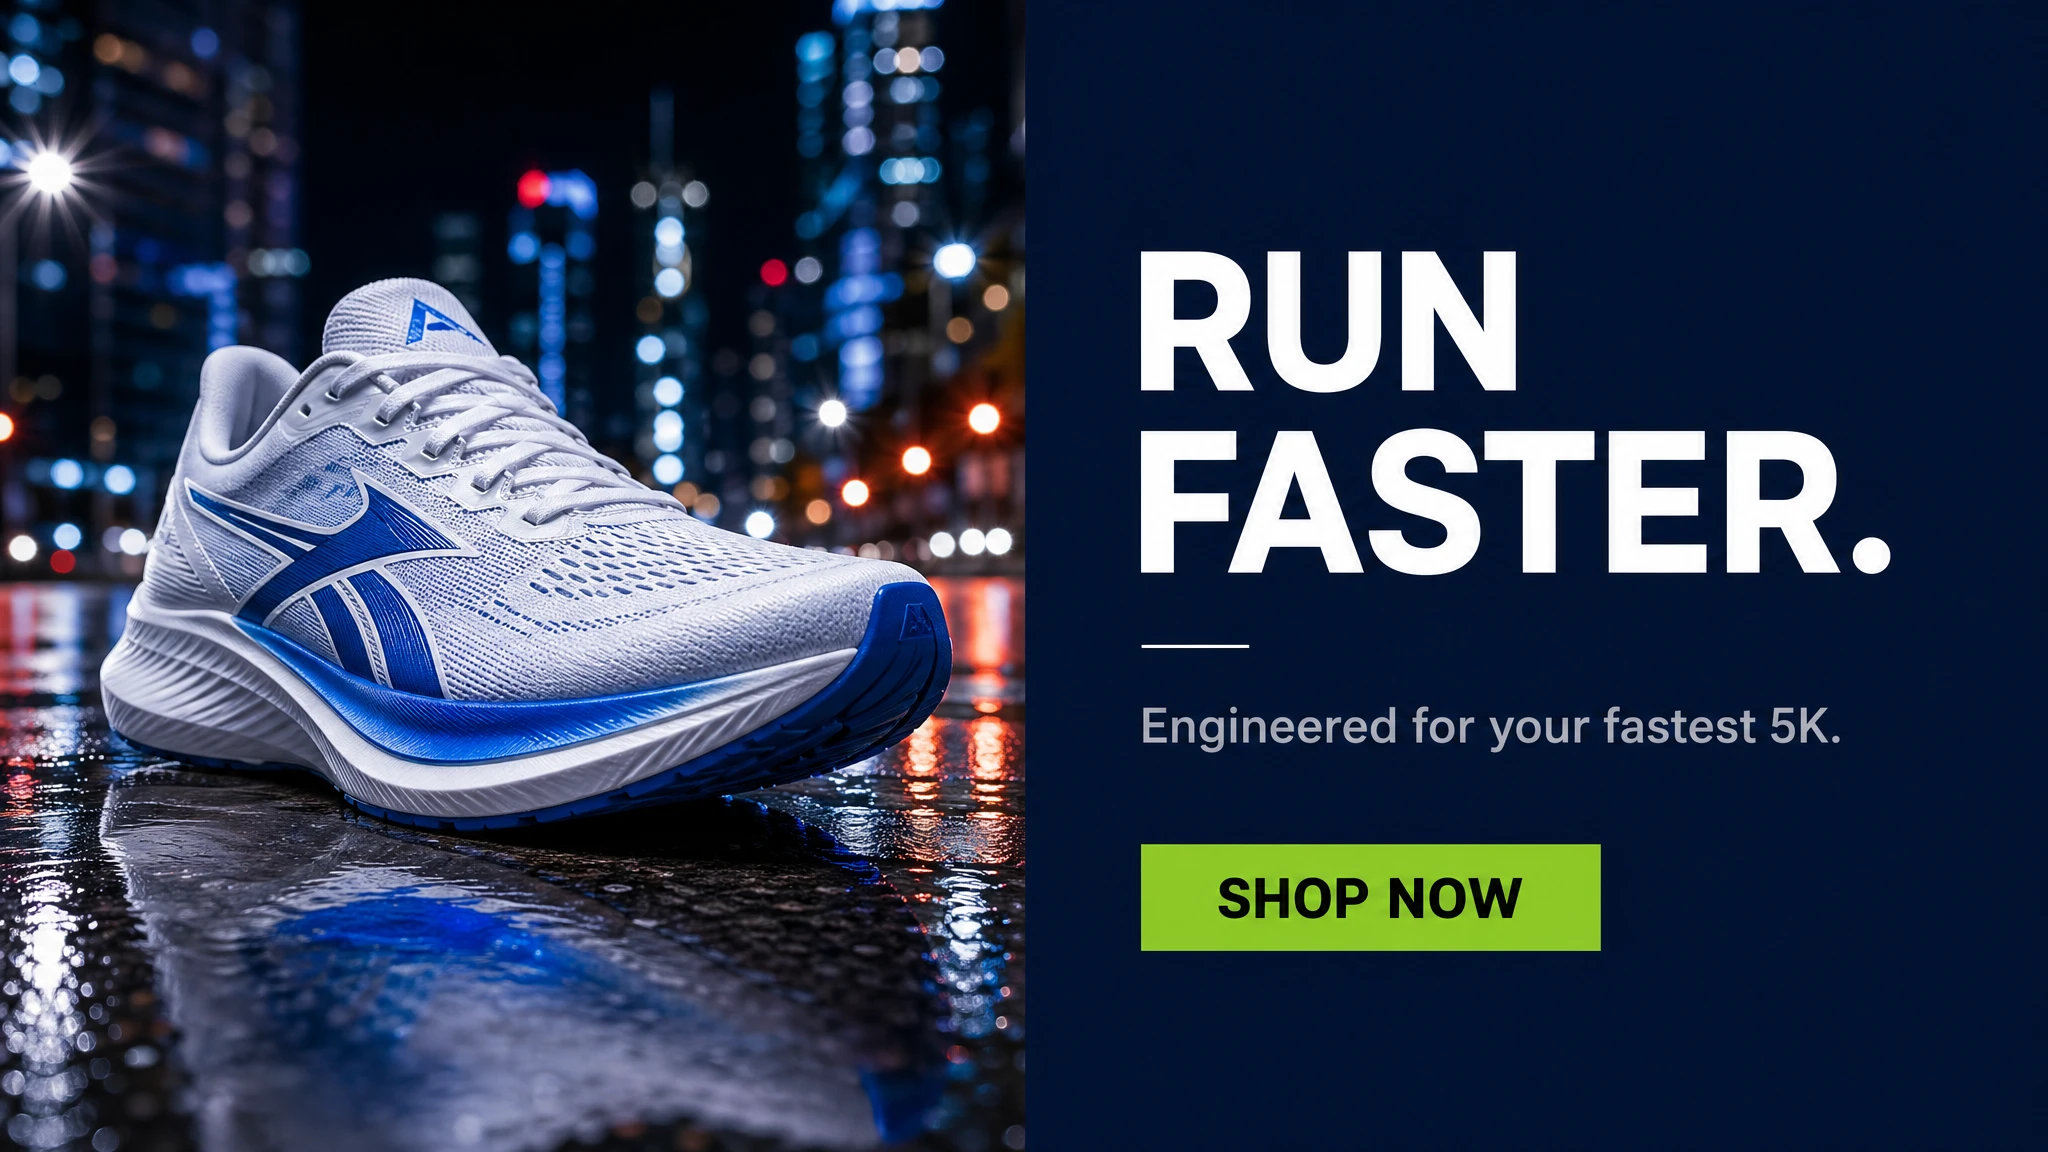
5. Creative publicitario de marketing con texto en la imagen
Los equipos de marketing superponían texto en imágenes generadas por IA en Figma o Photoshop porque el texto del modelo era poco confiable. GPT Image 2 elimina este paso: los titulares, las CTA y el cuerpo del texto se pueden especificar en el prompt y se renderizarán correctamente dentro de la imagen, listos para su implementación sin un pase de diseño separado.
Probamos un formato de anuncio en redes sociales — la variante más difícil de este flujo de trabajo, ya que requiere texto CTA correcto, imagen del producto y jerarquía de diseño en una sola generación.
Prompt
A clean social media ad for a premium running shoe brand. Split layout: left half shows a dramatic close-up of a white and electric blue running shoe on a wet asphalt surface reflecting city lights. Right half is a solid dark navy panel. On the navy panel, stacked vertically: bold white headline "RUN FASTER." then a small white separator line, then secondary copy in light grey "Engineered for your fastest 5K." then below that a solid lime green CTA button with the text "SHOP NOW" in black. All text must be perfectly legible. Modern, premium athletic aesthetic.
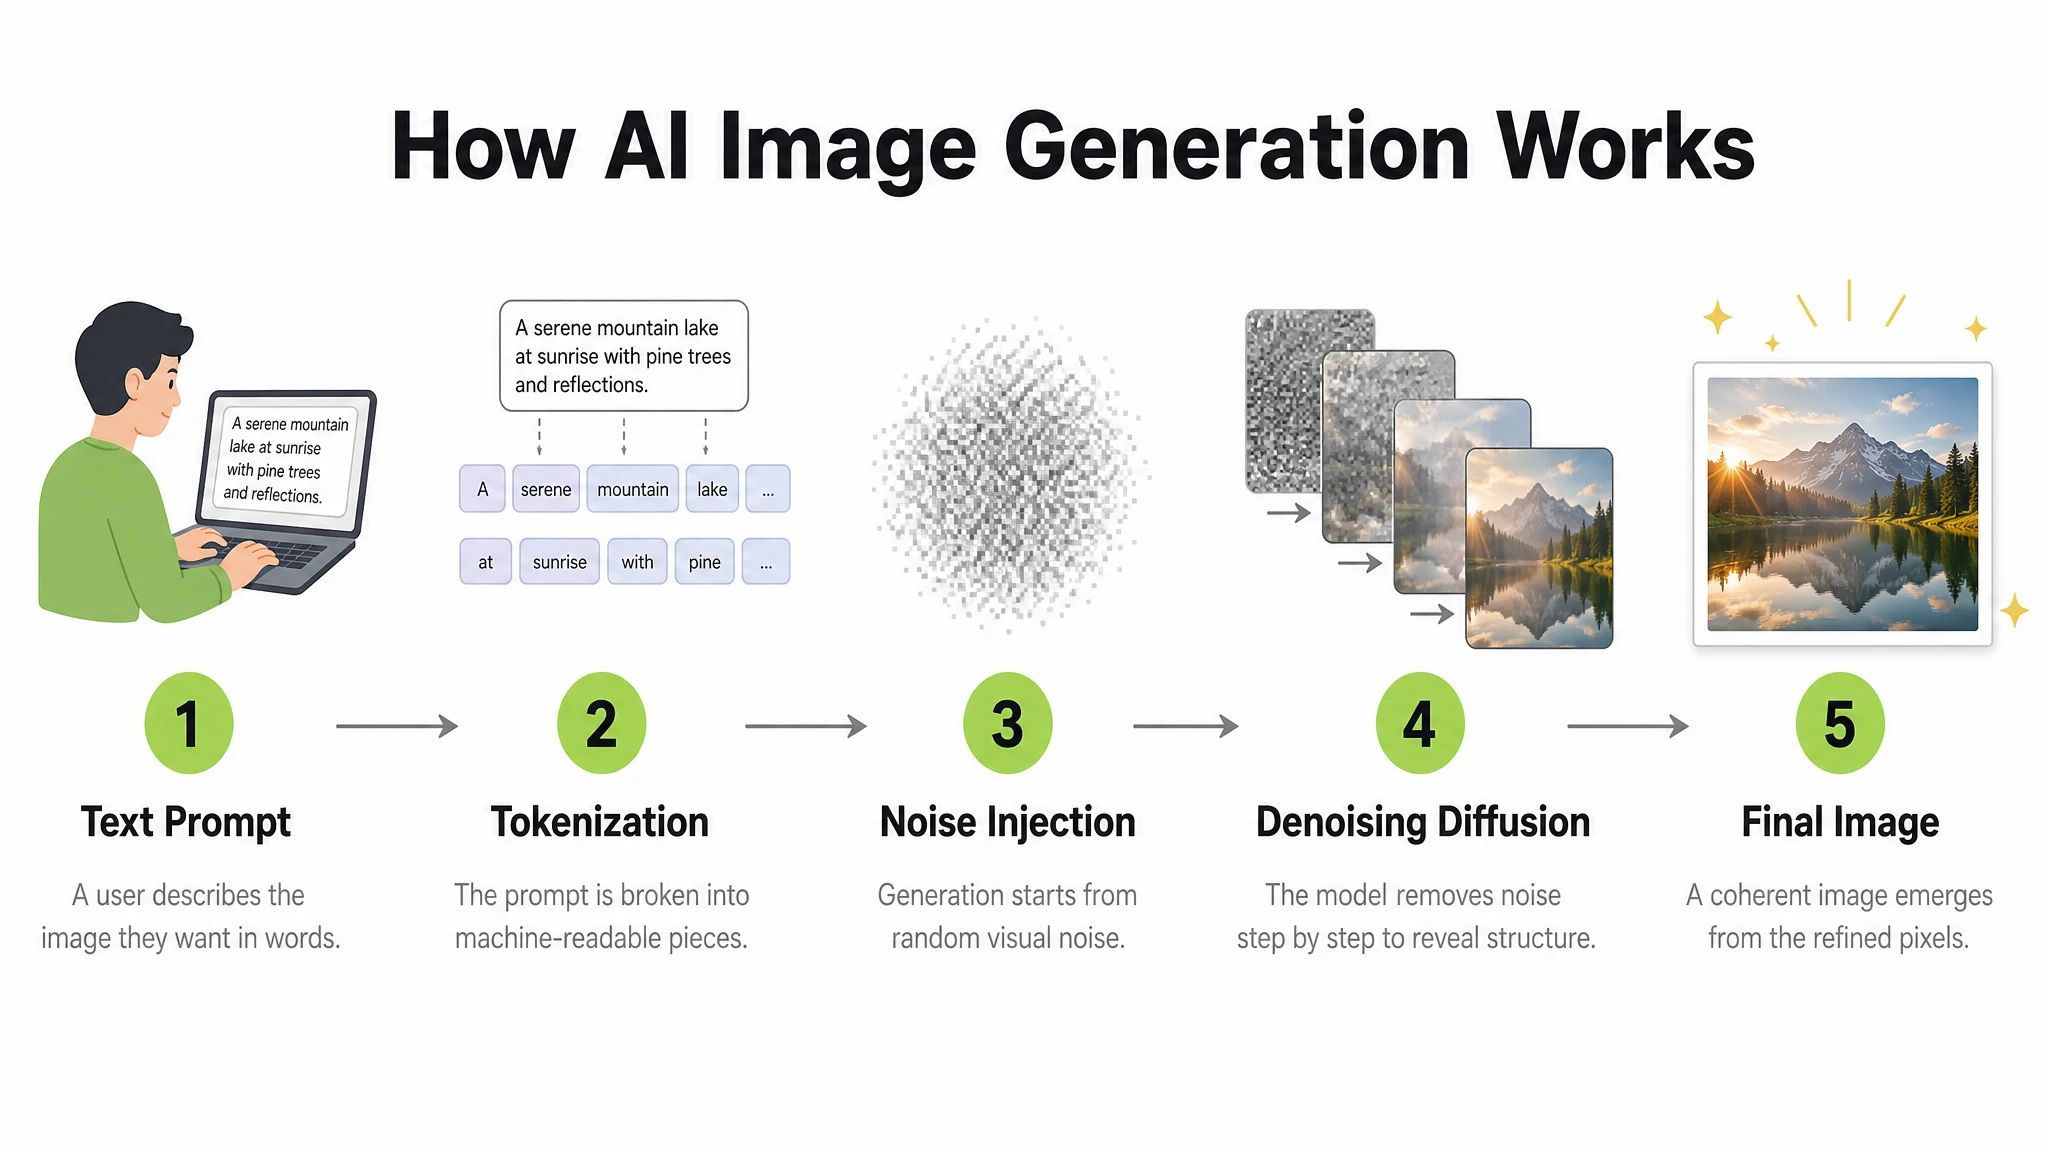
6. Infografía y diagrama paso a paso
Las infografías requieren que el modelo gestione simultáneamente el diseño, la jerarquía tipográfica, los iconos, las flechas direccionales y la precisión de la información — una combinación que falla a la mayoría de los modelos de imagen. GPT Image 2 maneja bien esta categoría para diagramas estilizados e instructivos.
Probamos un diagrama educativo paso a paso con etiquetas numeradas y conectores de flecha.
Prompt
A clean, modern educational infographic titled "How AI Image Generation Works" showing 5 steps in a left-to-right horizontal flow. Step 1: "Text Prompt" — icon of a person typing. Step 2: "Tokenization" — text being split into tokens. Step 3: "Noise Injection" — abstract Gaussian noise cloud. Step 4: "Denoising Diffusion" — blurry image sharpening. Step 5: "Final Image" — glowing completed photograph. Each step has: a bold number in a lime green circle, a simple flat icon above, the step title in bold dark text, and a one-line description in lighter grey below. Steps connected by clean horizontal arrows. White background. Clear typographic hierarchy. No decorative clutter.
7. Maqueta de UI y diseño de interfaz de aplicación
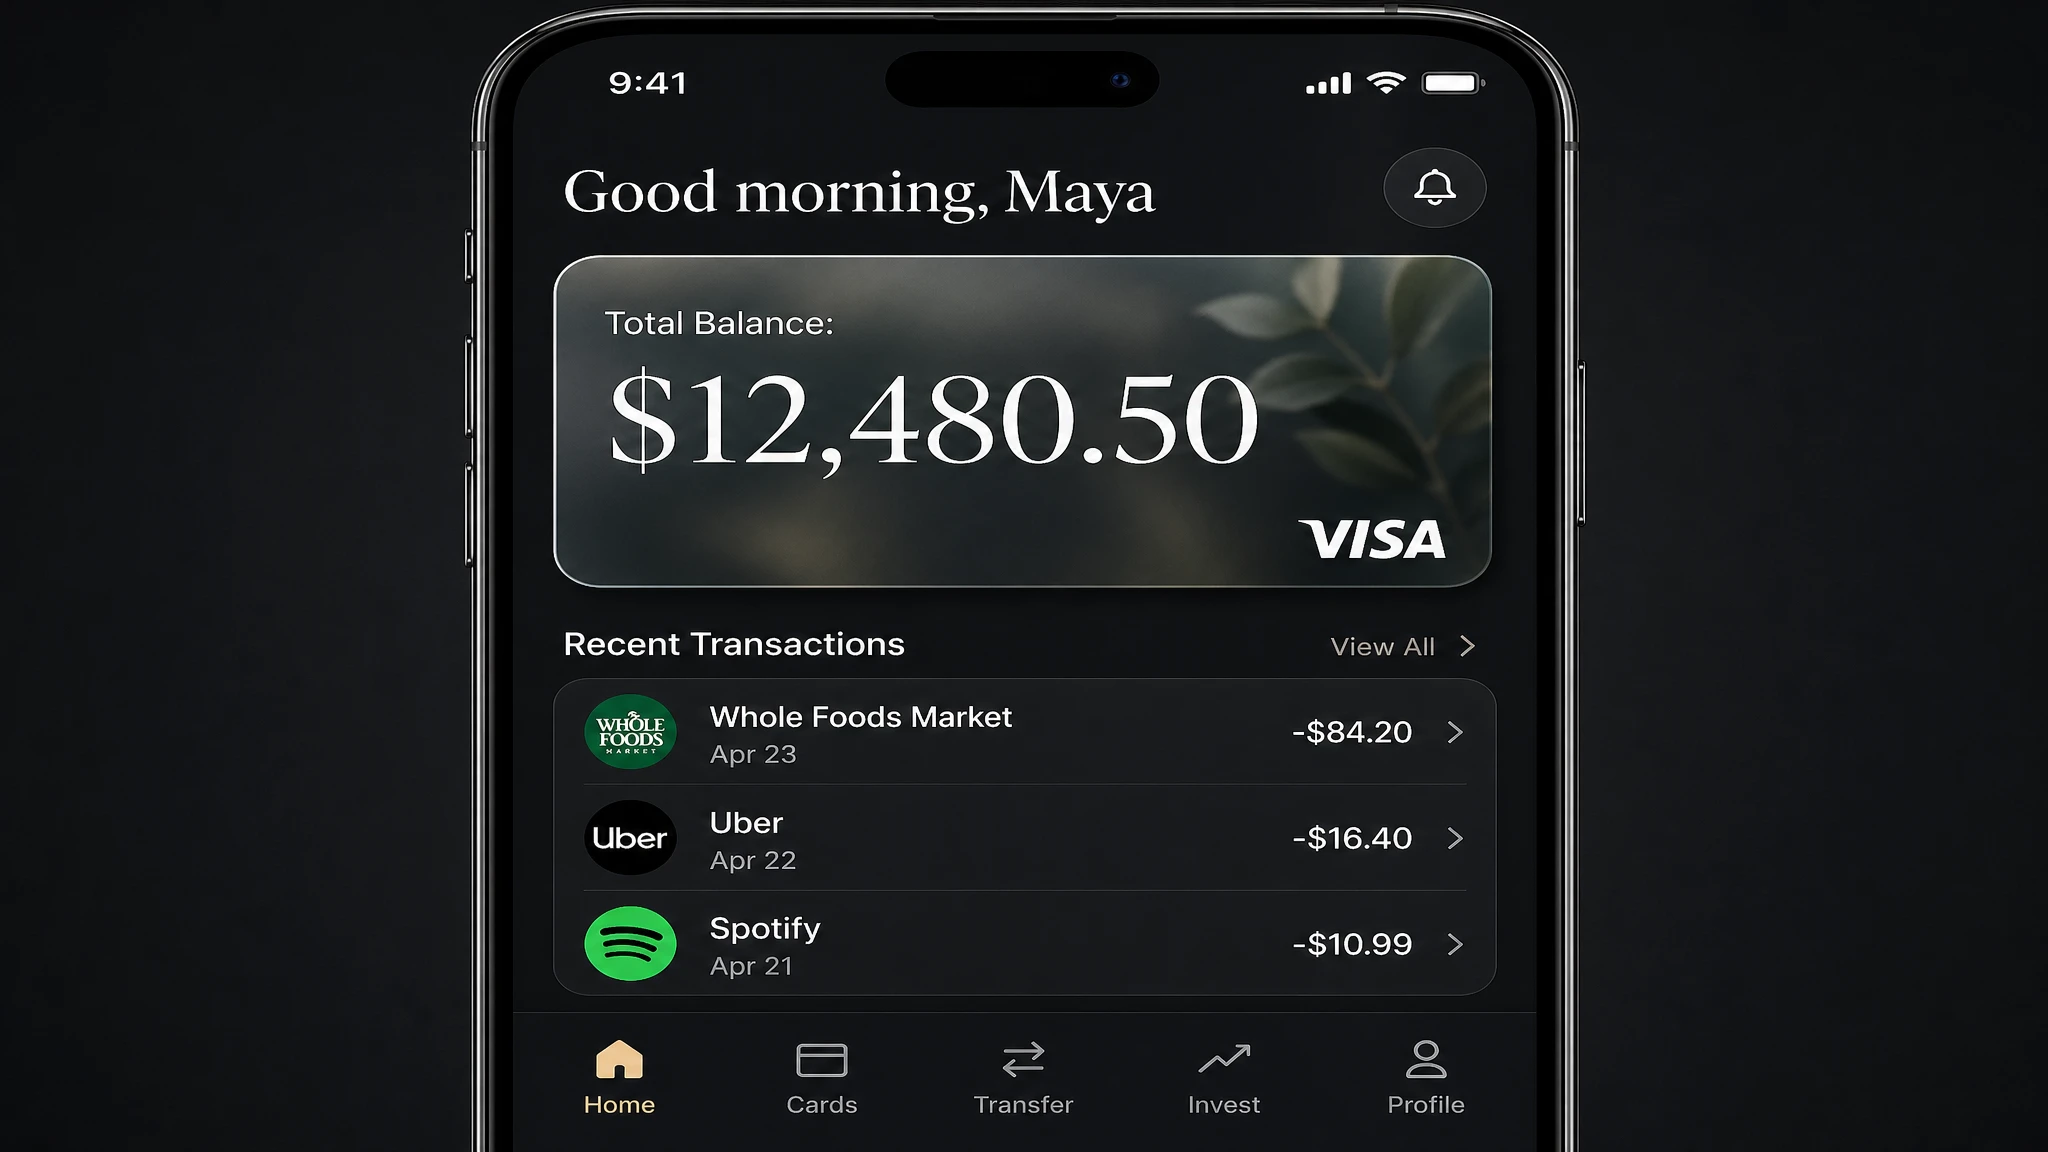
La generación de maquetas de UI es un nuevo caso de uso que GPT Image 2 maneja mejor que cualquier modelo anterior. La combinación de renderizado de texto preciso, razonamiento de diseño y detalle a nivel de icono hace posible generar una pantalla de aplicación o panel de control creíble sin una herramienta de diseño.
Probamos un panel de una aplicación bancaria móvil: un prompt con mucho diseño con etiquetas de navegación, saldos de cuenta, filas de historial de transacciones y un elemento de tarjeta.
Prompt
A photorealistic mobile app UI mockup for a premium digital bank. Dark charcoal background. Top section: user greeting "Good morning, Maya" in white. Below: a frosted glass card element showing "Total Balance: $12,480.50" in a large white serif, with a small visa logo in the bottom right. Below the card: a section titled "Recent Transactions" with three rows — each row has a category icon on the left, merchant name and date in the center, and amount on the right (e.g. "Whole Foods Market · Apr 23 · -$84.20"). Bottom navigation bar with five icons: Home, Cards, Transfer, Invest, Profile. All labels must be legible. Clean, minimal, premium fintech aesthetic.
Resultado: La cifra del saldo, las filas de transacciones y las etiquetas de navegación se renderizan correctamente. El elemento de tarjeta de vidrio esmerilado tiene translucidez precisa. Útil como mood board o prototipo para partes interesadas — no código listo para producción, pero suficiente para comunicar la dirección del diseño sin un archivo Figma.
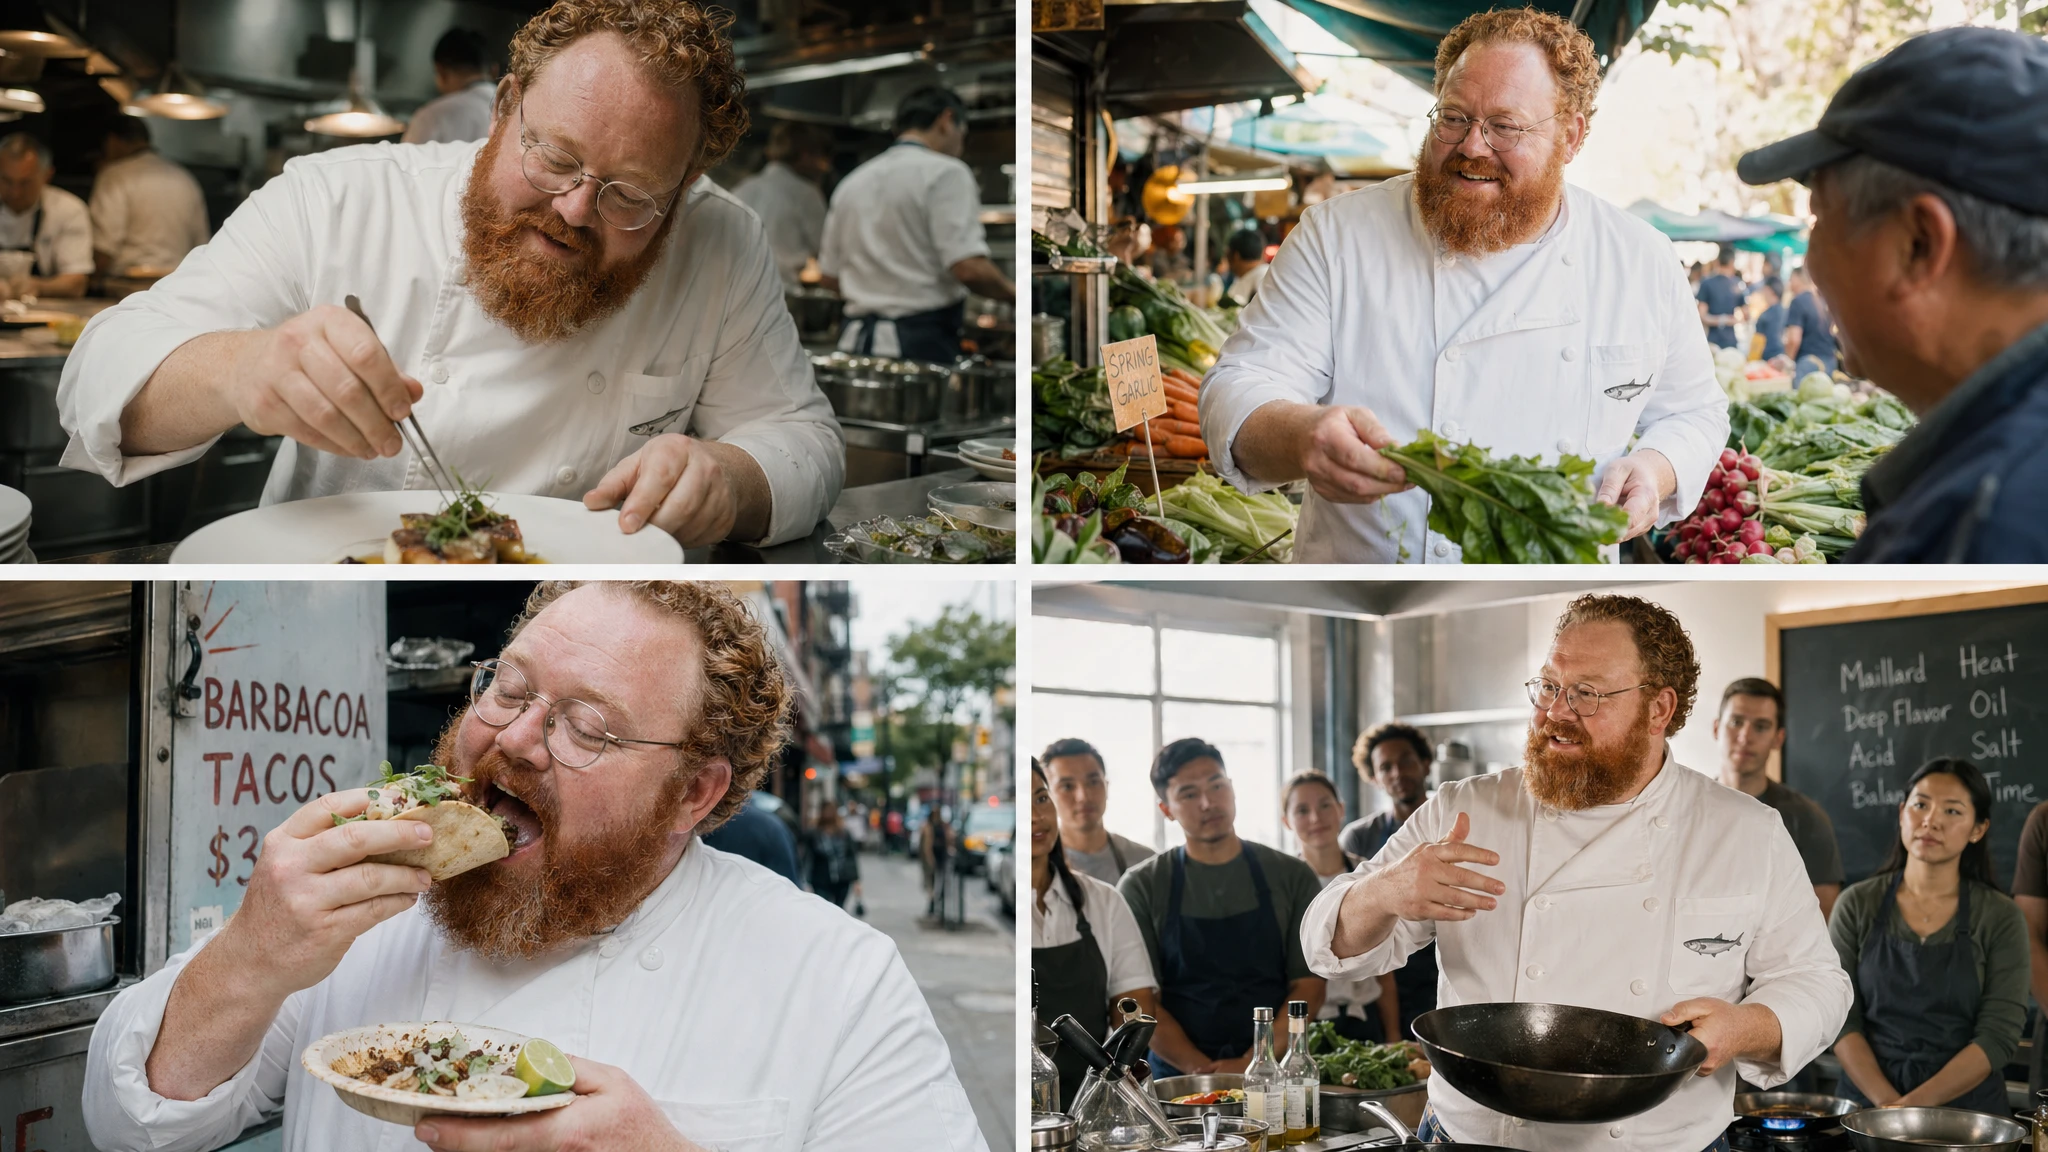
8. Modo Thinking: Consistencia de múltiples imágenes
El modo Thinking es la capacidad más diferenciada de GPT Image 2 y su mayor brecha con respecto a cualquier otro modelo de generación de imágenes actual. Cuando está activado, el modelo razona sobre el prompt antes de generar — gastando más o menos cómputo dependiendo de la complejidad — y puede buscar en la web durante esa fase de razonamiento.
Esto es directamente útil para ilustración de libros infantiles, storyboards, campañas de marca secuenciales y arte conceptual de videojuegos. El acceso al modo Thinking requiere una suscripción a ChatGPT Plus, Pro, Business o Enterprise.
Prompt
Generate 4 scenes featuring the same character: Chef Milo, a cheerful stocky man in his 40s with a thick red-orange beard, round wire-rimmed glasses, and a white double-breasted chef coat with a small anchovy embroidered on the chest pocket. Scene 1: Milo in a busy open kitchen, plating a dish with tweezers, intense concentration. Scene 2: Milo at a morning market, selecting vegetables, smiling at a vendor. Scene 3: Milo eating a street taco by a food cart, genuine delight on his face. Scene 4: Milo teaching a cooking class, holding a carbon steel wok, students visible in the background. Keep Milo's face, beard, glasses, and coat identical across all four scenes. Cinematic photography style.
Esto es genuinamente nuevo: ninguna otra API de generación de imágenes ofrece salida de lote de múltiples imágenes con continuidad de personajes en una sola llamada. Para contenido secuencial — storyboards, historias ilustradas, campañas de múltiples escenas — esto cambia fundamentalmente la ecuación de producción.
9. Edición de imágenes en lenguaje natural
GPT Image 2 admite la edición de imágenes a través del endpoint /v1/images/edits. Carga una imagen existente y describe el cambio en lenguaje sencillo. El modelo aplica ediciones dirigidas sin regenerar la imagen completa, preservando identidad, composición e iluminación mientras modifica solo el elemento especificado.
Los intercambios de fondo, las adiciones de objetos, los cambios de iluminación, los ajustes de color de ropa y las transferencias de estilo funcionan solo mediante descripción de texto.
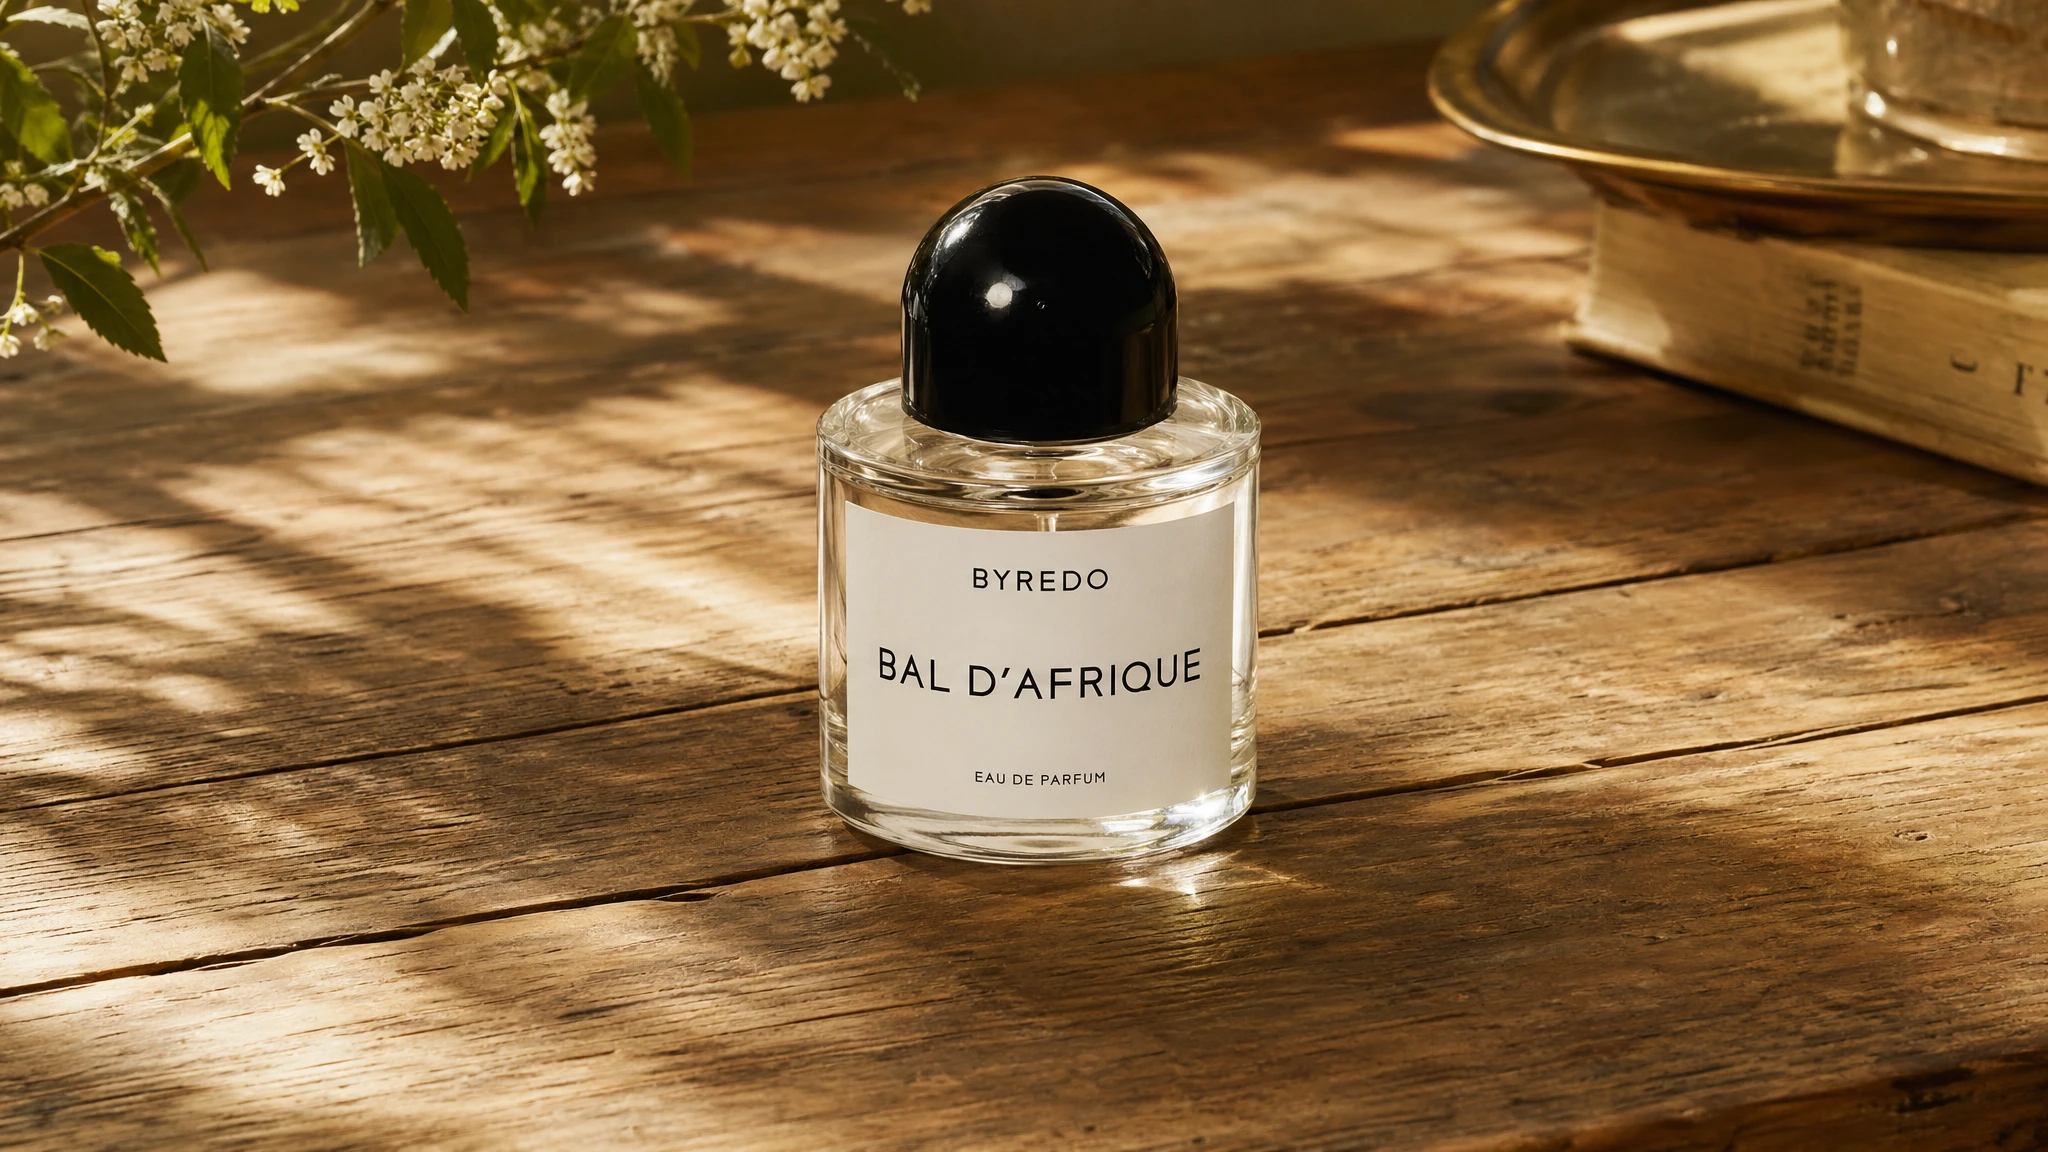
Prompt
[Edit instruction applied to an existing studio product shot of a glass perfume bottle on white background] Change the background from the plain white studio background to a warm, rustic wooden table surface with soft dappled sunlight coming from the left. Keep the bottle, its reflections, and its shadow exactly as they are. The new background should feel like a high-end lifestyle photograph taken in a sunlit Parisian apartment.
10. Control de estilo artístico y cinemático
GPT Image 2 cubre más de 50 estilos artísticos reconocidos, desde el fotorrealismo hasta el óleo, la acuarela, el anime, el pixel art, la impresión de trama y el ciberpunk neón. El modelo sigue fielmente los descriptores de estilo en los prompts sin derivar hacia una estética de IA genérica.
Probamos un fotograma cinemático de alto contraste: un género específico, una configuración de iluminación y un grado de color, todos especificados juntos.
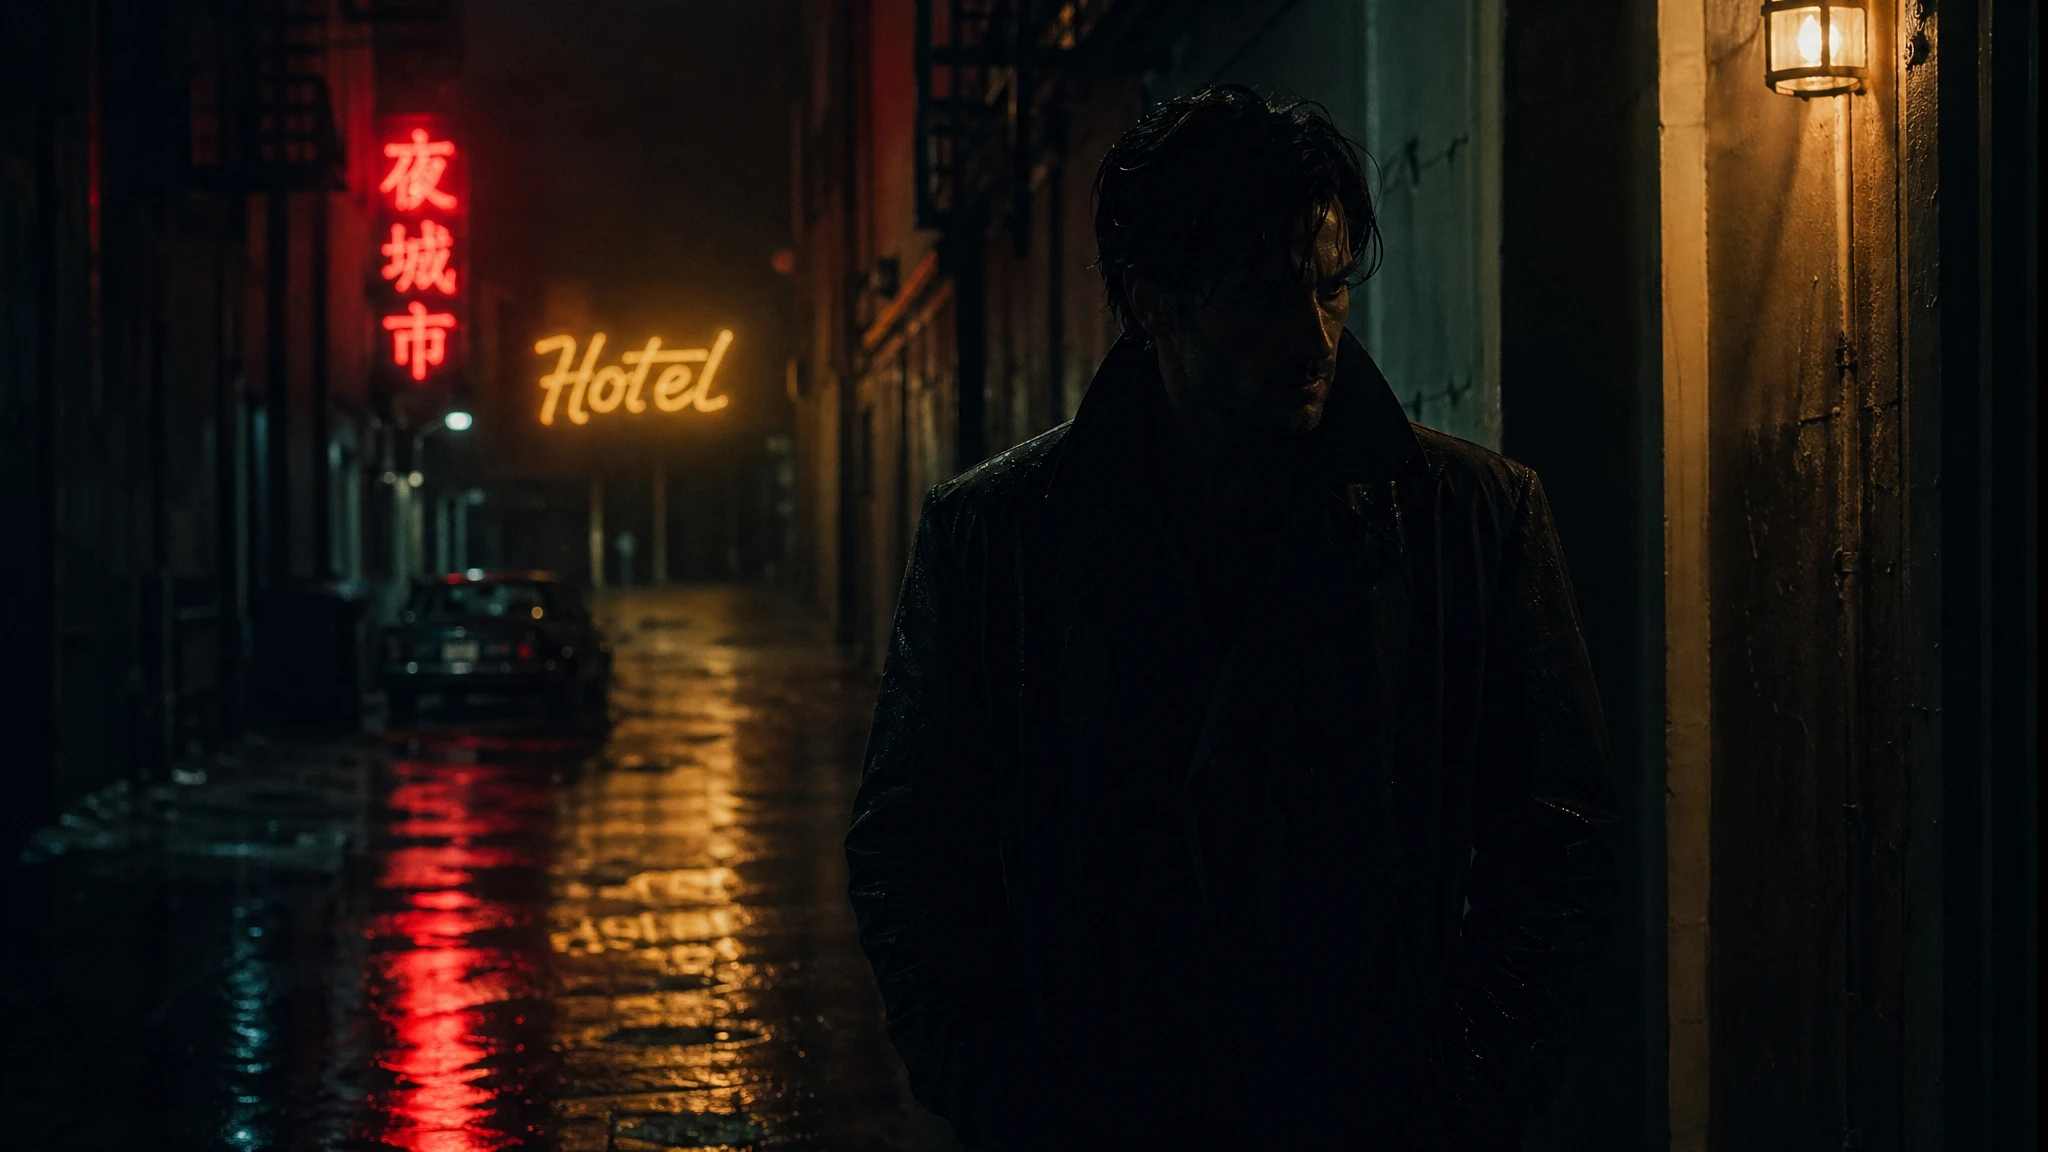
Prompt
A cinematic still in the style of contemporary neo-noir. A lone figure in a dark trench coat walks down a rain-slicked urban alley at 2am. Reflections of neon signs — one red kanji, one amber "HOTEL" in script — pool on the wet pavement. Shallow depth of field keeps the background signage slightly soft. Color grade: deep teal shadows, warm amber highlights — classic film noir color separation. Low-key side lighting from a practical wall sconce off screen right. The figure's face is partially in shadow. No dialogue. No motion blur. Shot on 35mm Kodak Vision3 500T. Aspect ratio 3:2.
11. Editorial de moda y fotografía de estilo de vida
La fotografía de moda y estilo de vida es una de las categorías de mayor valor para GPT Image 2 en producción. El modelo renderiza texturas de tela — tejido de lino, grano de cuero, brillo de satén — con suficiente fidelidad para comunicar claramente los detalles de estilismo a un equipo de diseño.
Capacidad clave: GPT Image 2 puede renderizar etiquetas de marca en prendas correctamente. Un prompt que especifica una etiqueta que dice 'ÉLISE PARIS' producirá una prenda con esa etiqueta legible en la imagen.
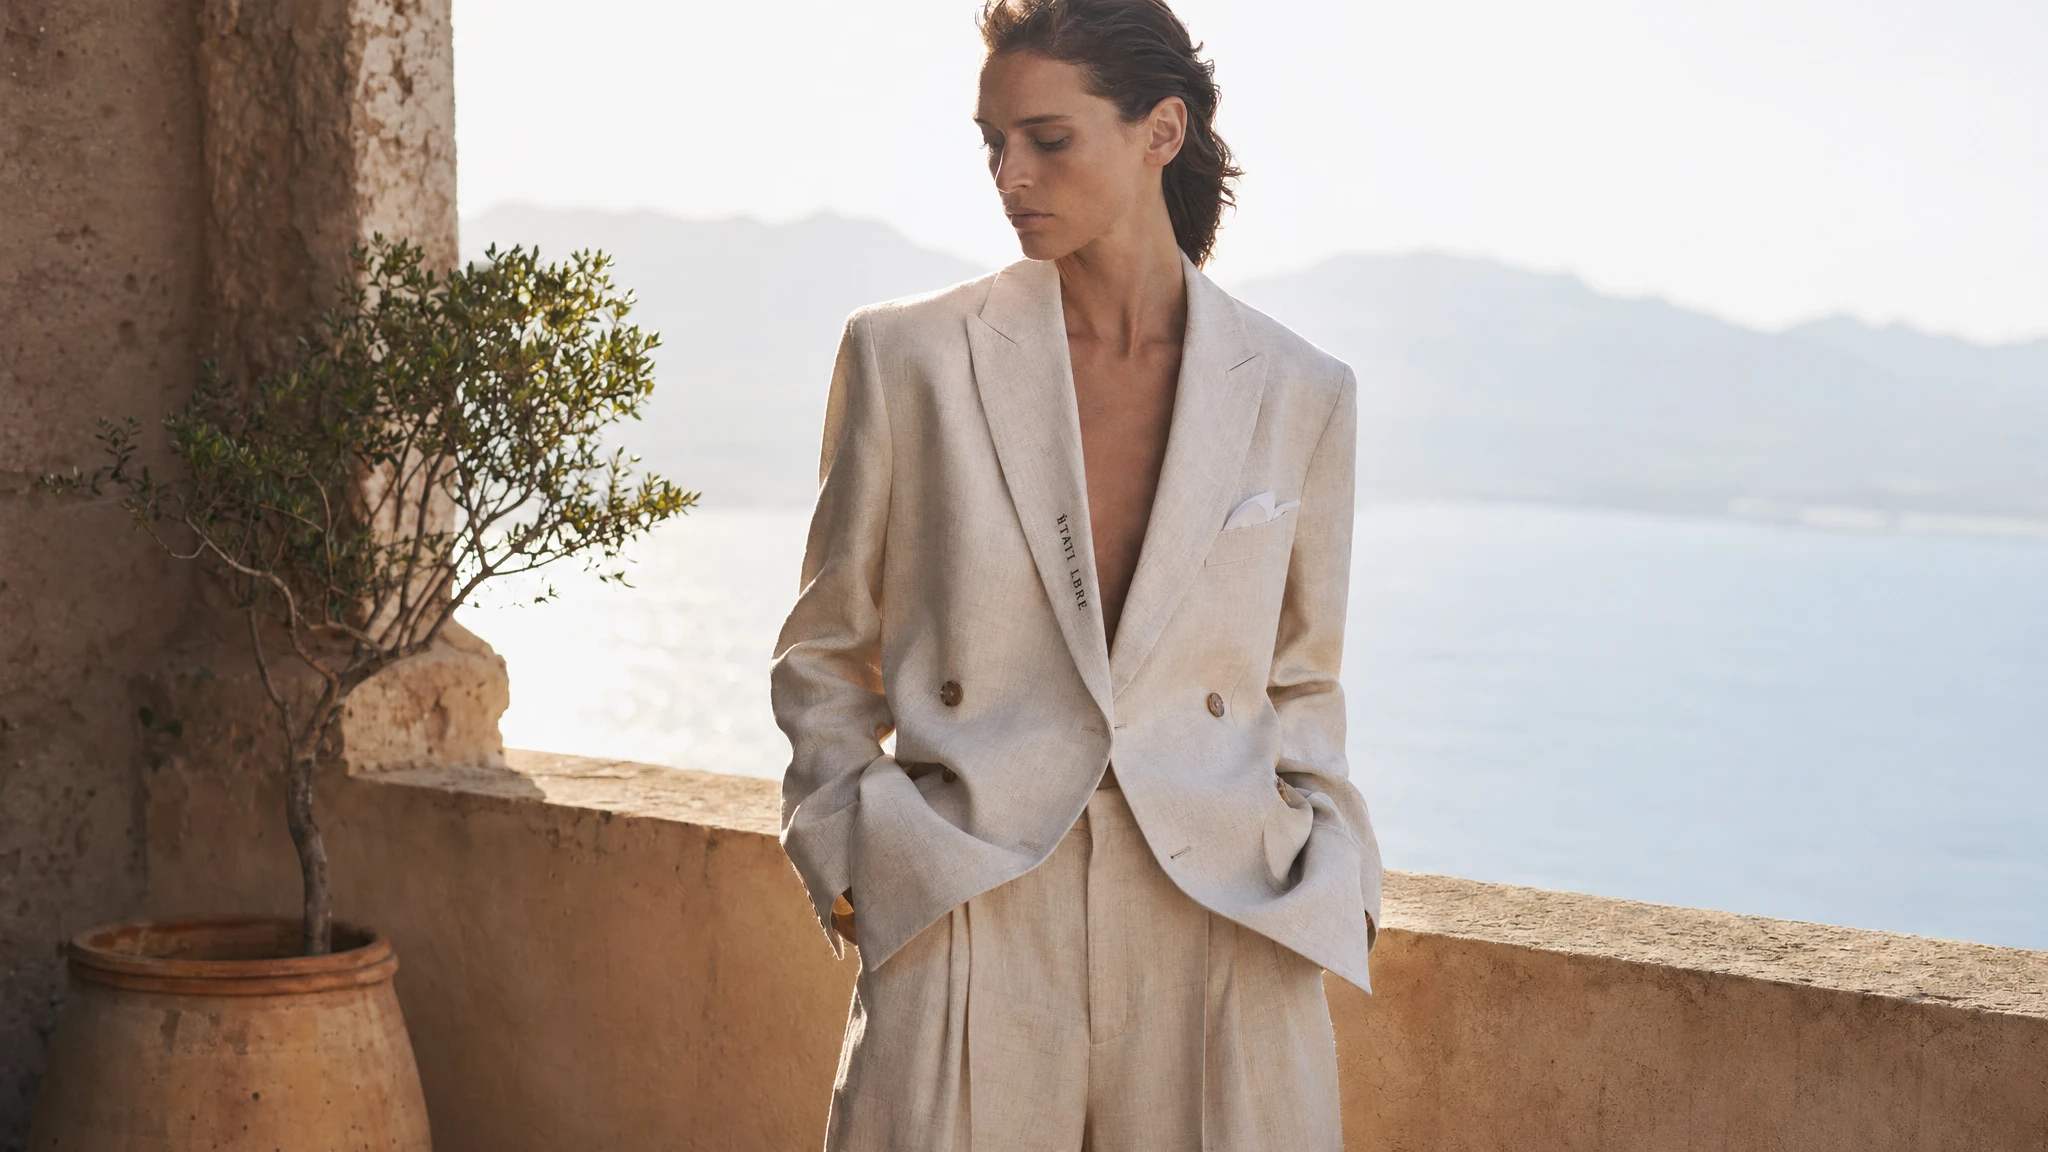
Prompt
An editorial fashion photograph. Subject: a tall woman in an oversized cream linen suit — wide-leg trousers with sharp creases and a boxy double-breasted blazer. The blazer has a small chest pocket with a folded white pocket square and a brand label visible on the inner lapel reading "ÉTAT LIBRE". She stands on a sun-bleached stone terrace overlooking the Mediterranean Sea, golden hour light behind her creating a natural rim light on her silhouette. Shot on medium format, 80mm equivalent. The linen fabric texture and stitching are clearly visible. Expression: composed, distant, slightly downward gaze.
12. Precisión de escenas del mundo real con Grounding de búsqueda web
En el modo Thinking, GPT Image 2 puede buscar en la web antes de generar. Esto importa para prompts que hacen referencia a sujetos del mundo real: edificios específicos, logotipos de marcas, monumentos culturales o diseños de productos actuales.
El límite de conocimiento de GPT Image 2 es diciembre de 2025. Para cualquier sujeto que haya cambiado o aparecido después de esa fecha, la búsqueda web del modo Thinking mitiga parcialmente la brecha.
Probamos un monumento del mundo real renderizado en un estilo artístico específico — un prompt que requiere tanto precisión factual sobre la apariencia del edificio como ejecución estilística.
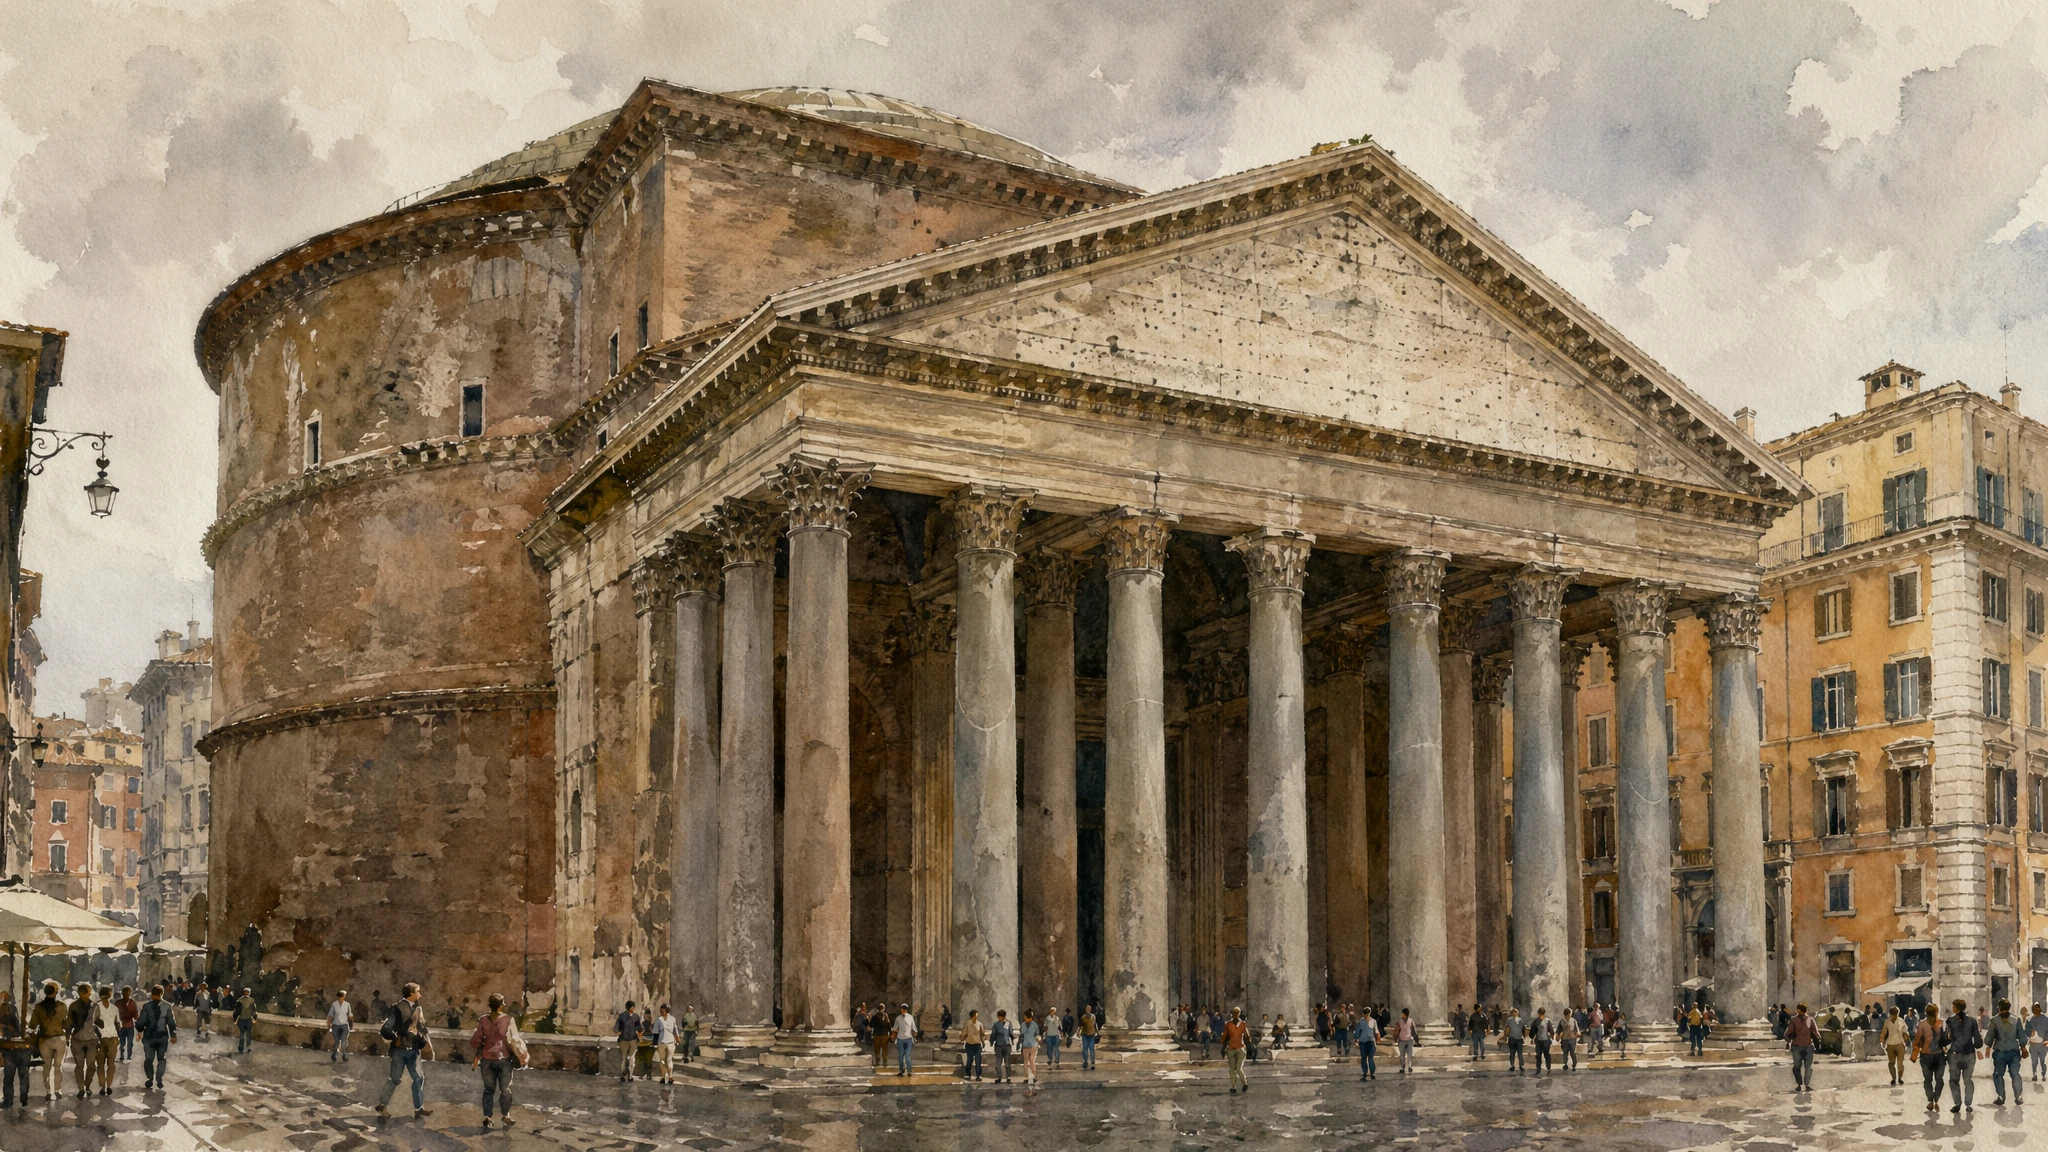
Prompt
Search the web for visual references of the Pantheon in Rome, then generate an image of it in loose architectural watercolor style. The painting should accurately reflect the real building's proportions: the massive Corinthian portico with sixteen granite columns in three rows, the triangular pediment, and the cylindrical drum behind it. Medium: loose warm-toned watercolor with deliberate wet-on-wet washes, visible paper texture, and dry brush strokes on the column edges. A small crowd of tourists in simple gestural marks at street level. Overcast soft Roman morning light. No text. Aspect ratio 3:2.
Resultado: El recuento de columnas y las proporciones del pórtico en la imagen generada coinciden con el Panteón real — 16 columnas, frontón triangular correcto, relación de profundidad correcta entre el pórtico y el tambor de la rotonda.
Limitaciones conocidas
- Límite de conocimiento: diciembre de 2025. Los eventos, diseños de productos y figuras públicas que surgieron después de esa fecha pueden producir salidas incorrectas o rechazadas. La búsqueda web del modo Thinking mitiga esto parcialmente.
- Fondos transparentes no compatibles: Para gpt-image-2, el fondo transparente no está actualmente soportado. El parámetro background: "transparent" no es compatible. Use exportaciones PNG de otros modelos o procese posteriormente.
- Árabe y hebreo con diacríticos completos en tamaños de punto pequeños: Aproximadamente un error de glifo por 20 caracteres en párrafos densos. La señalización básica y los titulares funcionan de manera confiable.
- Cuerpo de texto denso en tamaños de punto muy pequeños: ~95 % de precisión por párrafo — suficiente para la mayoría de los usos, pero requiere verificación para activos tipográficamente precisos.
- Ediciones complejas de múltiples regiones: Las ediciones que requieren cambios simultáneos en tres o más regiones espaciales distintas pueden necesitar 2-3 iteraciones para un resultado limpio.
- Latencia del modo Thinking: Las generaciones complejas de múltiples imágenes pueden tardar hasta 2 minutos por lote. No adecuado para requisitos en tiempo real o de menos de 5 segundos.
- Límites de velocidad bajo carga de ráfaga: Las cargas de ráfaga de API pesadas pueden activar limitaciones de velocidad en cuentas de Nivel 1-2. Planifique retroceso exponencial en integraciones de producción.
Resumen: Cuándo usar GPT Image 2
| Caso de uso | Estándar de calidad | Capacidad clave utilizada | Mejor configuración de calidad |
|---|---|---|---|
| Creative publicitario con texto en imagen | Listo para producción | Renderizado de texto | Alta |
| Fotografía de producto | Listo para producción | Fotorrealismo, textura de material | Alta |
| Maqueta de embalaje | Pitch/prototipo | Renderizado de texto en superficie 3D | Alta |
| Maqueta de UI / prototipo de app | Alineación con partes interesadas | Razonamiento de diseño, precisión de texto | Media |
| Infografía / diagrama | Listo para producción | Texto + diseño | Media o Alta |
| Fotografía de retrato | Listo para producción | Renderizado sensible a la identidad | Alta |
| Editorial de moda | Prototipo / campaña | Control de estilo, textura de tela | Alta |
| Libro infantil / storyboard | Listo para producción | Consistencia multimagen (modo Thinking) | Media |
| Escena de monumento real | Representación precisa | Grounding de búsqueda web (modo Thinking) | Alta |
| Miniatura para redes sociales | Listo para producción | Composición + texto en imagen | Baja o Media |
| Arte conceptual / fotograma cinemático | Exploración creativa | Control de estilo artístico | Media |
| Iteración rápida / lote de borradores | Revisión interna | Velocidad y coste | Baja |
GPT Image 2 es la opción más sólida para cualquier flujo de trabajo donde la precisión del renderizado de texto sea un requisito — embalaje, creatividad de marketing, infografías, maquetas de UI, diseños editoriales. También es el único modelo que ofrece generación de lotes de múltiples imágenes con continuidad de personajes en una sola llamada a la API.
Para flujos de trabajo que priorizan la exploración de estilos artísticos abstractos, la máxima velocidad o el menor costo por imagen a escala, evalúe alternativas junto a GPT Image 2 en su conjunto de prompts específico antes de comprometerse con una pila.