GPT Image 2 徹底レビュー:12の実例で主要ユースケースを網羅
GPT Image 2——ChatGPT Images 2.0としても提供——は2026年4月21日にリリースされました。これはOpenAI初の独立した画像生成モデルです。GPT-4oパイプラインから切り離され、シングルパス推論で再構築され、OpenAIの画像モデルラインナップで初めてネイティブ推論能力をアーキテクチャに組み込んだモデルです。
主要スペック:テキストレンダリング精度99%超、ネイティブ2K解像度(4K横長まで対応)、アスペクト比3:1の超横長から1:3の超縦長まで、そしてThinkingモードでは1つのプロンプトから最大8枚の一貫したキャラクターを持つ画像を生成できます。
12の本番向けユースケースでテストしました。以下の各例は、表示されているプロンプトを使用してGPT Image 2で生成されています。
GPT Image 1.5からの変更点
| 機能 | GPT Image 1.5 | GPT Image 2 |
|---|---|---|
| アーキテクチャ | GPT-4o画像パイプライン(2段階) | 独立モデル、シングルパス推論 |
| 最大解像度 | 1536×1024(横長) | 3840×2160(4K横長) |
| テキストレンダリング精度 | 〜70%(ラテン文字のみ) | 99%超、多言語対応 |
| 推論の統合 | なし | ネイティブThinkingモード(Web検索付き) |
| マルチ画像バッチ | 非対応 | 1プロンプトで最大8枚(Thinkingモード) |
| 自然言語編集 | 非対応 | 変更を説明するだけ — マスク不要 |
| アスペクト比の範囲 | 1:1と固定プリセット | 3:1〜1:3、制約内の任意の解像度 |
| APIモデル文字列 | gpt-image-1.5 | gpt-image-2 |
GPT Image 2はGPT-4oの画像更新ではありません。ゼロから再構築されています:出力PNGのメタデータが異なり、推論パスが異なり、テキストレンダリングパイプラインが全く異なります。OpenAIはこれを娯楽的な創作ツールではなく、本番ワークフロー向けに構築された「視覚的思考パートナー」と位置付けています。
1. フォトリアリスティックポートレート
ポートレートは依然として画像生成で最も厳しいベンチマークです:肌のテクスチャ、表面下散乱、被写界深度、顔のプロポーションがすべて同時に正確でなければなりません。GPT Image 2はモデル自身のドキュメントが「アイデンティティセンシティブ」レンダリングと呼ぶ手法でこれを処理します——中央クロップだけでなく、フレーム全体にわたって細部が維持されます。
テストでは、特定の照明とレンズ特性を指定してクローズアップポートレートを生成しました。後処理なし、アップスケールなし——高品質設定、1024×1024でモデルから直接出力。
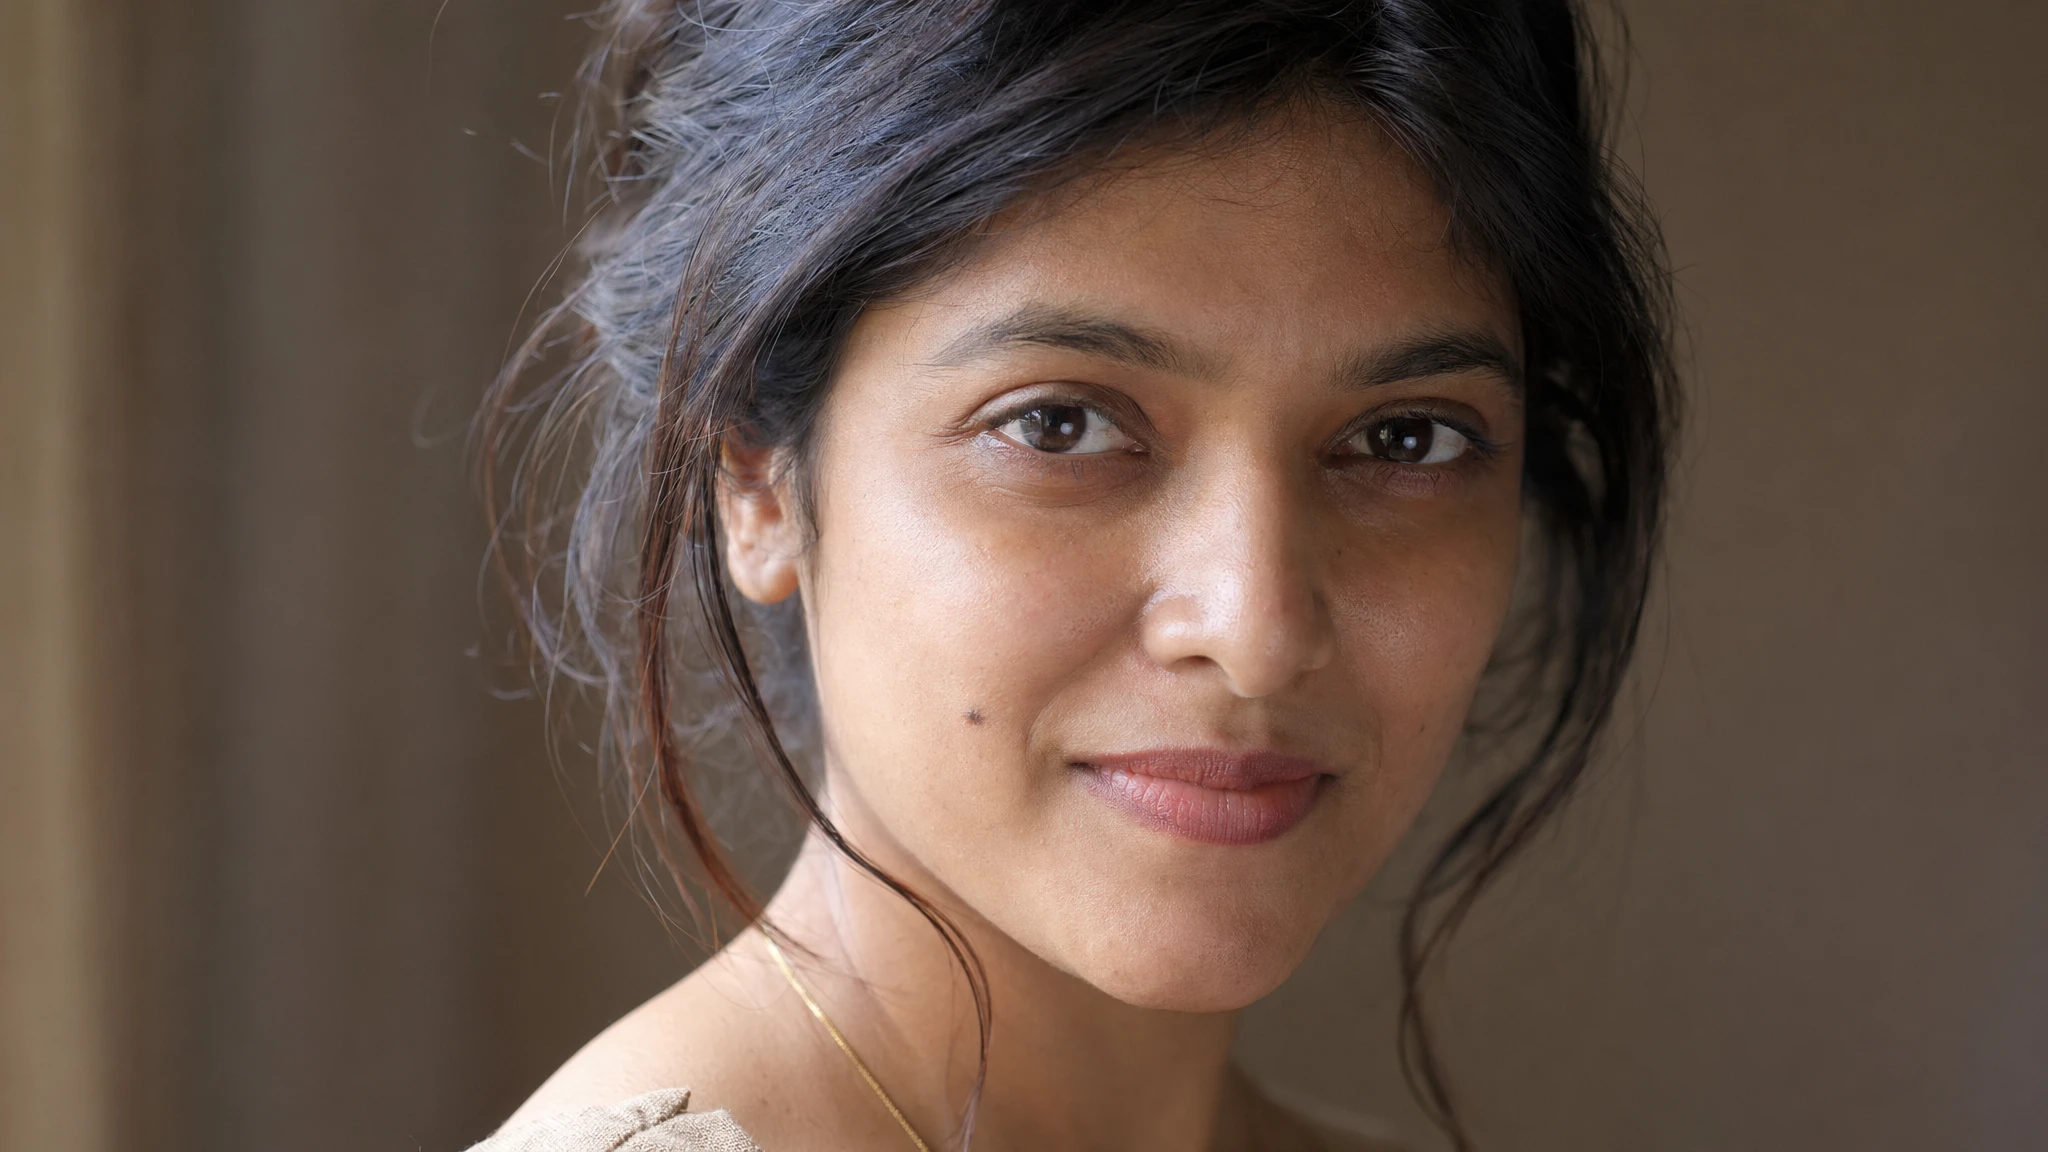
プロンプト
A photorealistic close-up portrait of a South Asian woman in her late 20s, soft diffused window light from the upper left, very shallow depth of field with background completely out of focus, warm neutral background, 85mm lens perspective. Ultra-fine skin texture — visible pores, subtle smile lines near the eyes, one small birthmark on the left cheek. Dark brown eyes, natural makeup. Hair loosely pinned, a few strands falling forward. Shot on a medium format digital camera. No filters. No color grading.
結果:肌のテクスチャは毛穴レベルでレンダリングされています。照明方向は物理的に一貫しています——「左上からの窓光」という指定だけで、右側のシャドウフィル、耳の縁のリムライトが自然に表現されています。ほくろと笑い皺が存在します。これは高品質モード1024×1024の品質の下限です。
2. 多言語テキストレンダリング
テキストレンダリングはGPT Image 2の代表的な能力であり、競合モデルとの最大の差異点です。OpenAIはこれを、拡散プロセス中にピクセルごとに文字形状を推測しようとするのではなく、ラスタライズ前にベクター形状としてグリフを書く書体パスの導入によって実現しました。
実用的な結果:英語、日本語、韓国語、アラビア語、中国語、トルコ語、ヘブライ語のテキストが、ほとんどの場合、初回の試みで正確にレンダリングされます。密集した複数行のレイアウト、混合スクリプトのポスター、成分リスト付きのパッケージコピーは、もはや出荷前に人間のQAを必要としません。
日英混合テキストの音楽フェスティバルポスターをテストしました——正確な漢字の筆順とクリーンなラテン語ディスプレイ書体の両方を必要とするため、テキストレンダリングシナリオの中でも難易度が高い部類です。
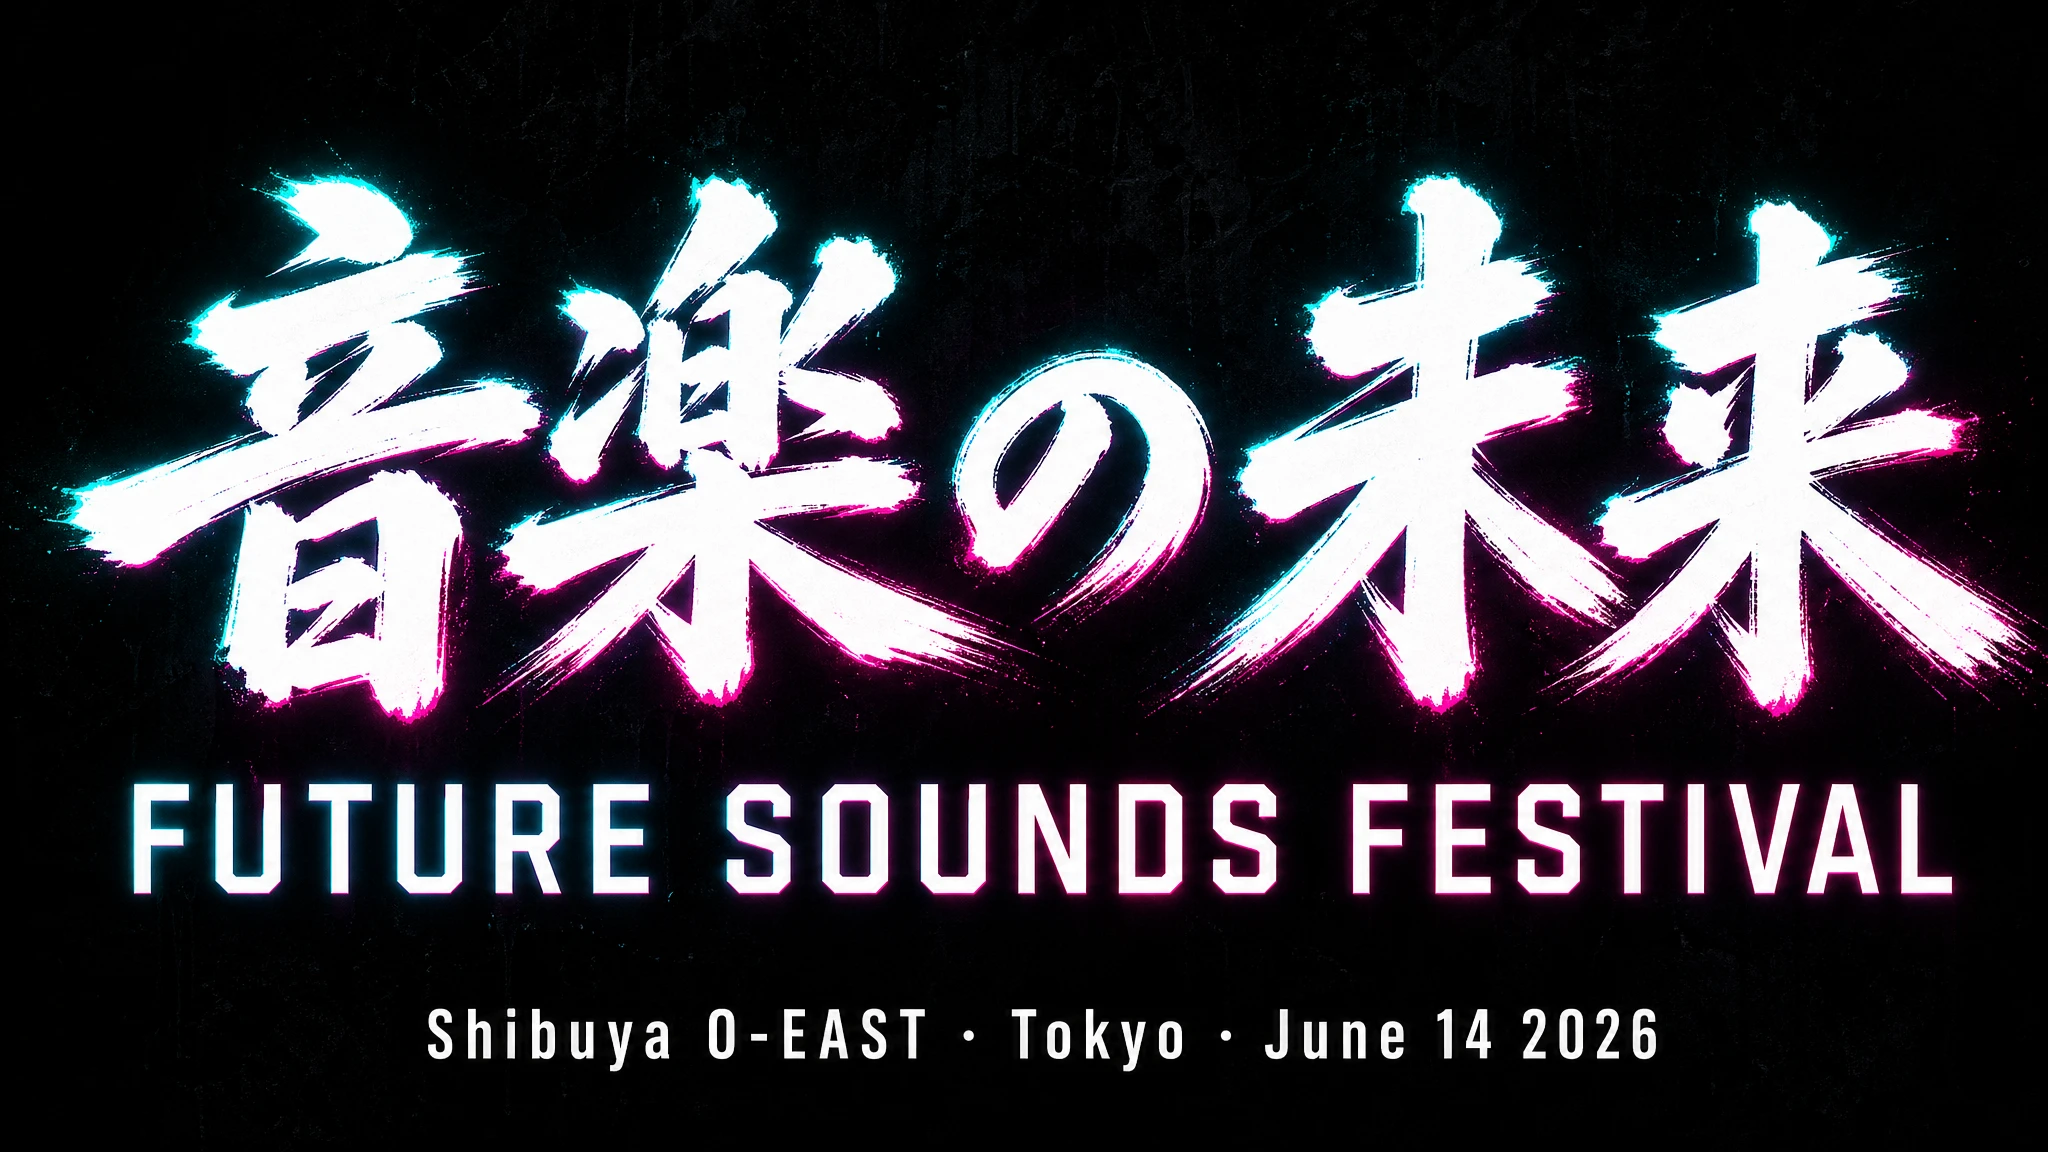
プロンプト
A bold music festival poster. Headline: "音楽の未来" in large brushstroke kanji, centered at the top third. Directly below it in a clean geometric sans-serif: "FUTURE SOUNDS FESTIVAL". Venue and date in smaller white type at the bottom: "Shibuya O-EAST · Tokyo · June 14 2026". Dark background, electric teal and magenta neon glow. All text must be fully legible and correctly formed. No decorative elements that obscure the type.
結果:すべての漢字の筆順が正確に形成されています。英語の見出しと会場行は完全に読み取れます。既知の制限:非常に小さなポイントサイズでの完全な記号付きアラビア語とヘブライ語は、密集した段落でまれに単一グリフエラーが発生します。標準サイズのサインとポスターコピーについては、精度は本番対応レベルです。
3. 製品写真
ECサイト向け製品写真はGPT Image 2の最も商業的価値の高いユースケースの1つです。以前は1SKUあたり500〜2,000ドルのコストがかかっていたチームが、わずかなコストでスタジオ相当の画像を生成できるようになりました。モデルは反射、表面シャドウ、マテリアルテクスチャ——ガラス、マットメタル、クラフト紙、セラミック——、マクロ撮影距離での正確な被写界深度を処理します。
プレミアムスキンケアのフラットレイ写真をテスト。ガラス上の正確な鏡面ハイライト、読み取れるラベルテキスト、説得力のある花びらの配置が必要なため、ベンチマークプロンプトカテゴリです。
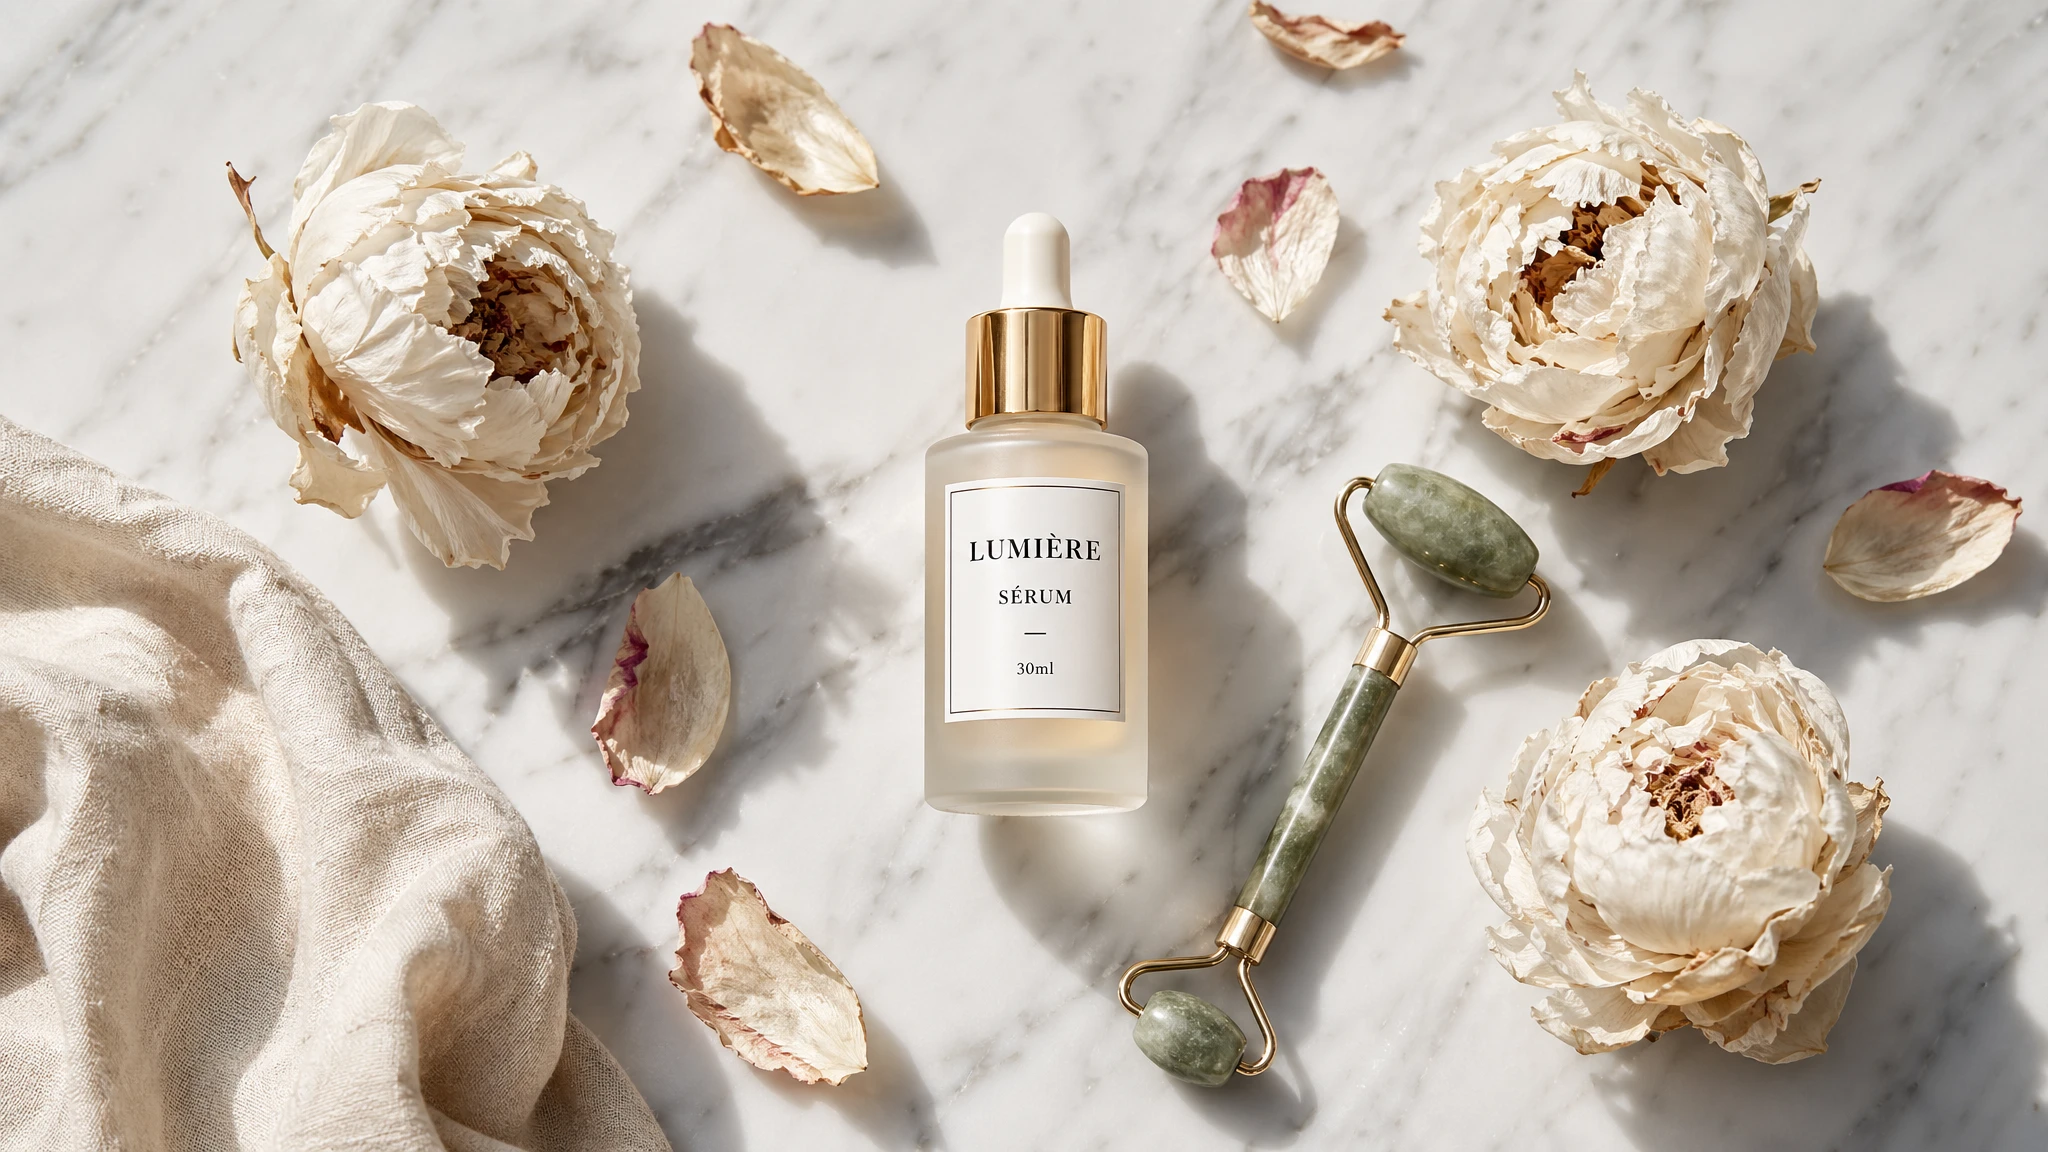
プロンプト
A high-end skincare flat lay on a smooth white marble surface. Center: a frosted glass serum bottle with a gold dropper cap. The label reads "LUMIÈRE SÉRUM — 30ml" in clean black serif type. Surrounding it: three dried white peonies, scattered rose petals, a small jade facial roller, and a cream-colored linen cloth slightly crumpled in the bottom-left corner. Soft north window light from above-left. Clean drop shadow under each object. No artificial studio look — feels like a magazine editorial. Shot from directly above. 16:9 crop.
結果:ラベルテキスト「LUMIÈRE SÉRUM — 30ml」はアクセント付きのÉを含めて正確にレンダリングされています。磨りガラスのテクスチャと金色のドロッパーキャップのハイライトは正確です。花びらの配置はアルゴリズム的な規則性ではなく有機的な見た目です。
4. 読み取れるラベルの付いた製品パッケージ
パッケージモックアップは最も難しいバージョンのテキストレンダリングを必要とします:成分リスト、栄養成分表、法的テキスト、ブランドタイポグラフィーが、曲面の歪みとマテリアルテクスチャのある3次元サーフェス上に表示されます。
GPT Image 2以前、これはデザインツールのコンポジットなしには不可能でした。成分パネルの文字はバラバラになり、バーコードは装飾的なノイズでした。GPT Image 2は、見出しだけでなく、正しいテキストでパッケージモックアップ全体をレンダリングできる最初のモデルです。
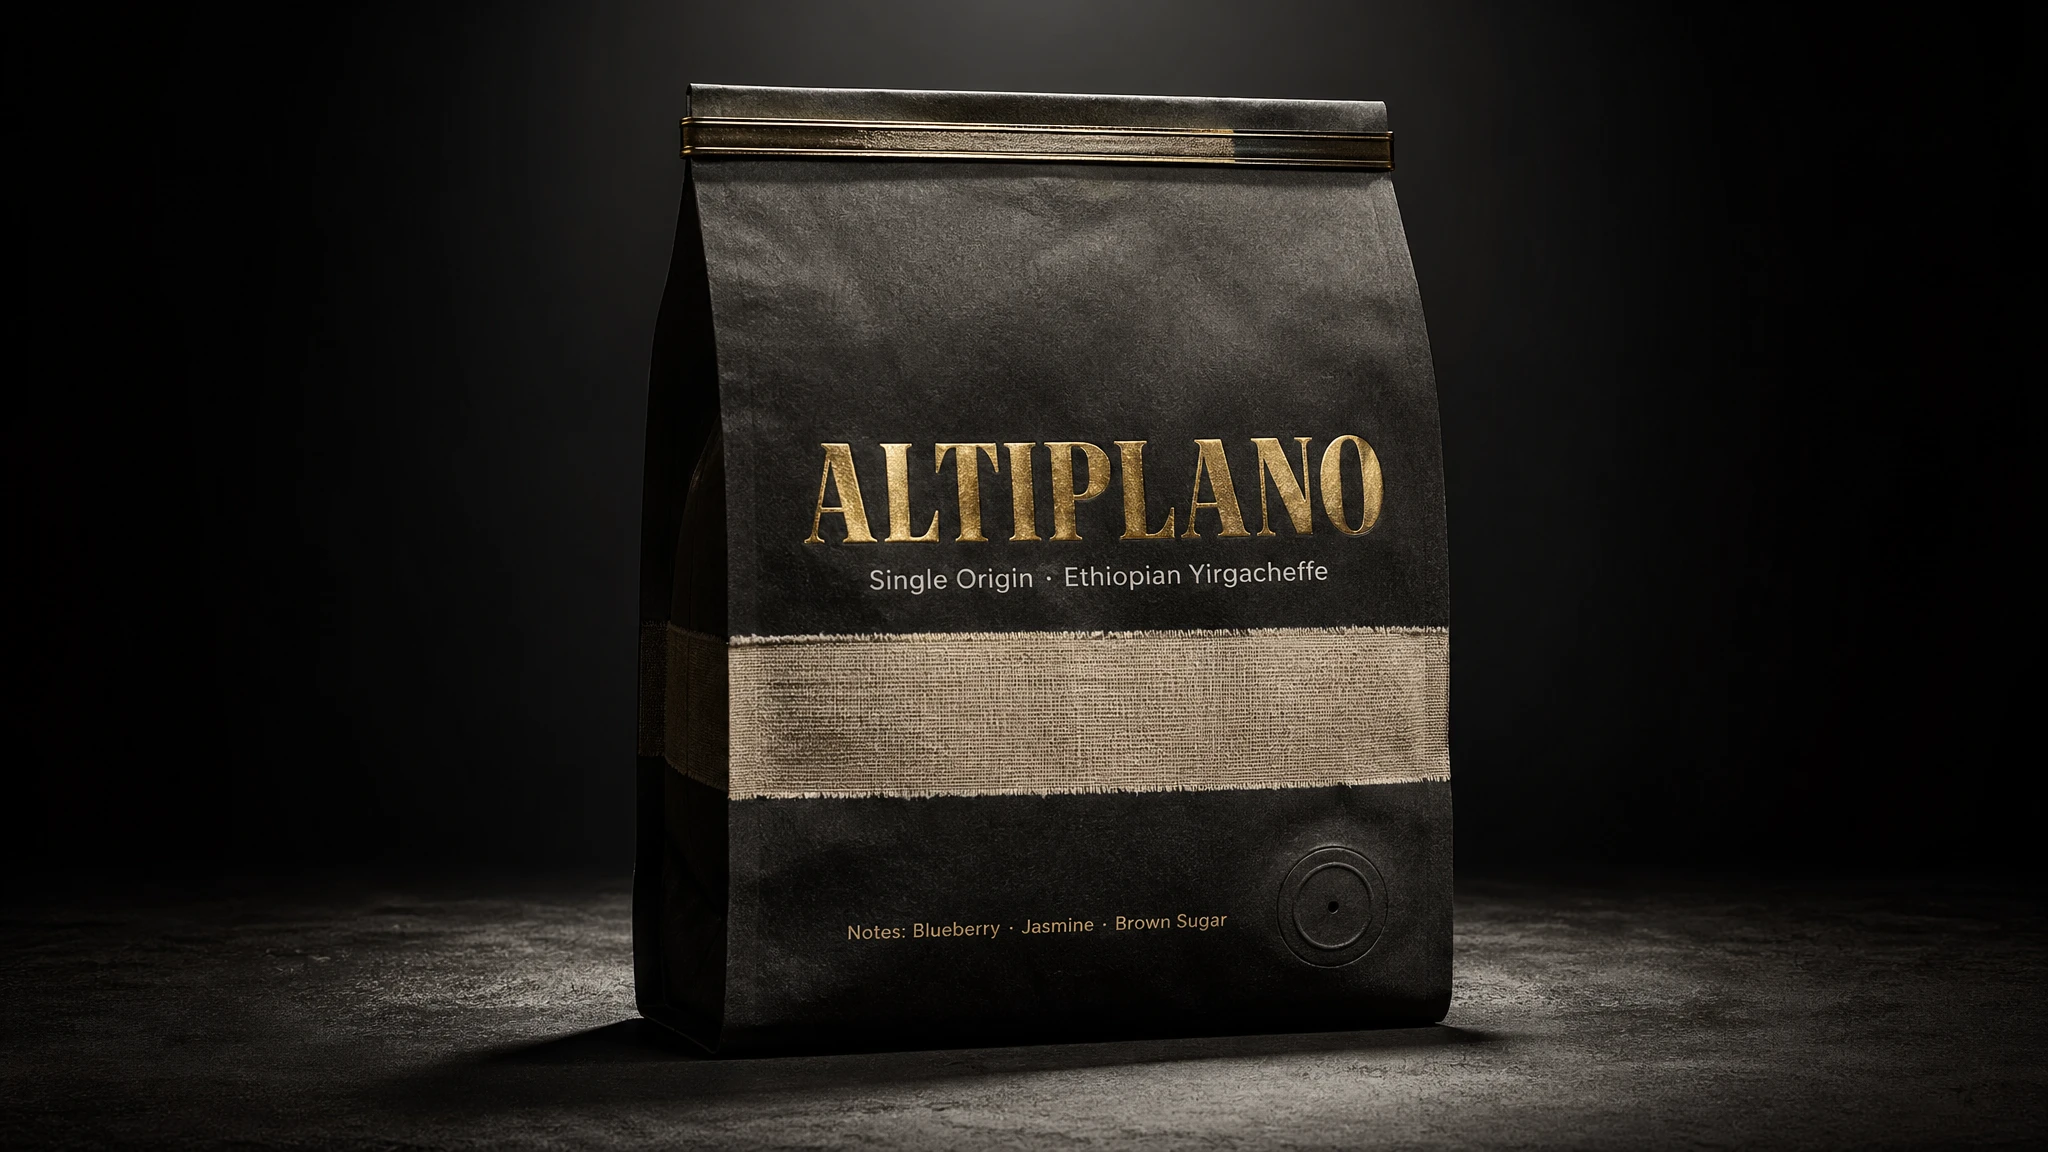
プロンプト
A photorealistic standing coffee bag mockup. The bag is matte black kraft paper with a natural linen texture stripe across the center. Brand name on the front: "ALTIPLANO" in a bold, wide uppercase serif, letterpressed in gold foil. Below it: "Single Origin · Ethiopian Yirgacheffe" in a smaller clean sans-serif. Bottom strip: "Notes: Blueberry · Jasmine · Brown Sugar". The bag has a tin-tie closure at the top and a circular degassing valve on the lower right. Dark studio background with a single dramatic spotlight from above. Realistic paper texture, no plastic sheen.
結果:サブタイトルとテイスティングノートを含むすべてのテキスト要素が正確にレンダリングされています。紙のテクスチャ、ティータイクロージャー、排気バルブは物理的に合理的です。修正なしでピッチデッキやECサイトの掲載画像として直接使用できます。
5. 画像内テキスト付きマーケティング広告クリエイティブ
マーケティングチームはモデルのテキストが信頼できなかったため、FigmaやPhotoshopでAI生成画像にテキストを重ねていました。GPT Image 2はこのステップを排除します:見出し、CTA、本文コピーをプロンプトで指定でき、別の設計フェーズなしにデプロイ準備完了の状態で画像内に正確にレンダリングされます。
ソーシャルメディア広告フォーマットをテスト——正確なCTAテキスト、製品画像、レイアウト階層が1回の生成で必要なため、このワークフローの最難関バリアントです。
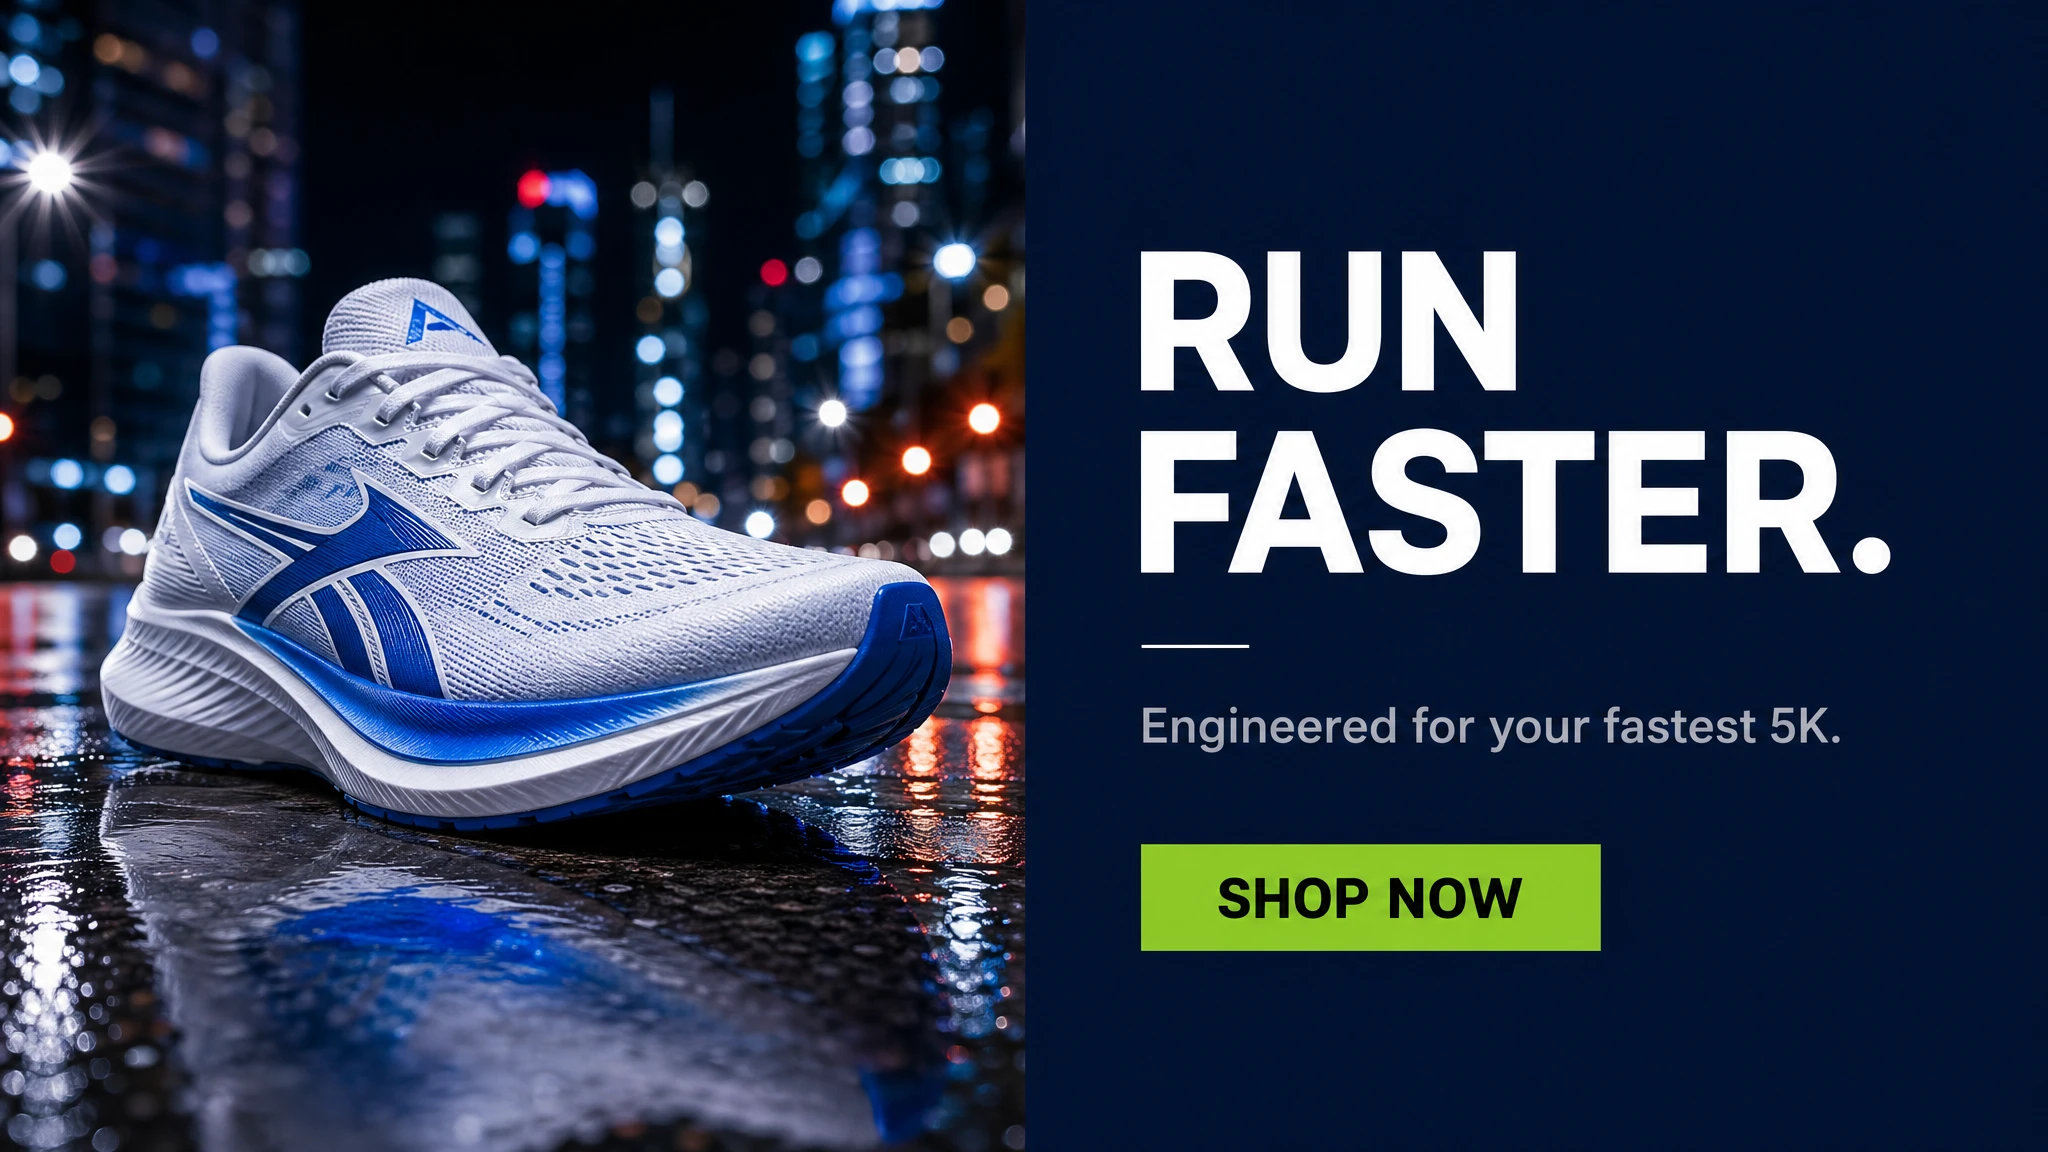
プロンプト
A clean social media ad for a premium running shoe brand. Split layout: left half shows a dramatic close-up of a white and electric blue running shoe on a wet asphalt surface reflecting city lights. Right half is a solid dark navy panel. On the navy panel, stacked vertically: bold white headline "RUN FASTER." then a small white separator line, then secondary copy in light grey "Engineered for your fastest 5K." then below that a solid lime green CTA button with the text "SHOP NOW" in black. All text must be perfectly legible. Modern, premium athletic aesthetic.
6. インフォグラフィックとステップバイステップ図解
インフォグラフィックはモデルがレイアウト、タイポグラフィー階層、アイコン、方向矢印、情報の正確さを同時に管理することを要求します——これはほとんどの画像モデルを失敗させる組み合わせです。GPT Image 2はスタイル化された教育的図解のカテゴリで優れた性能を発揮します。Thinkingモードは生成中にWebを検索することもでき、データ駆動型インフォグラフィックをもっともらしい近似値ではなく事実に基づいた情報に根拠付けます。
番号付きラベルと矢印コネクターを持つステップバイステップの教育図解をテストしました。
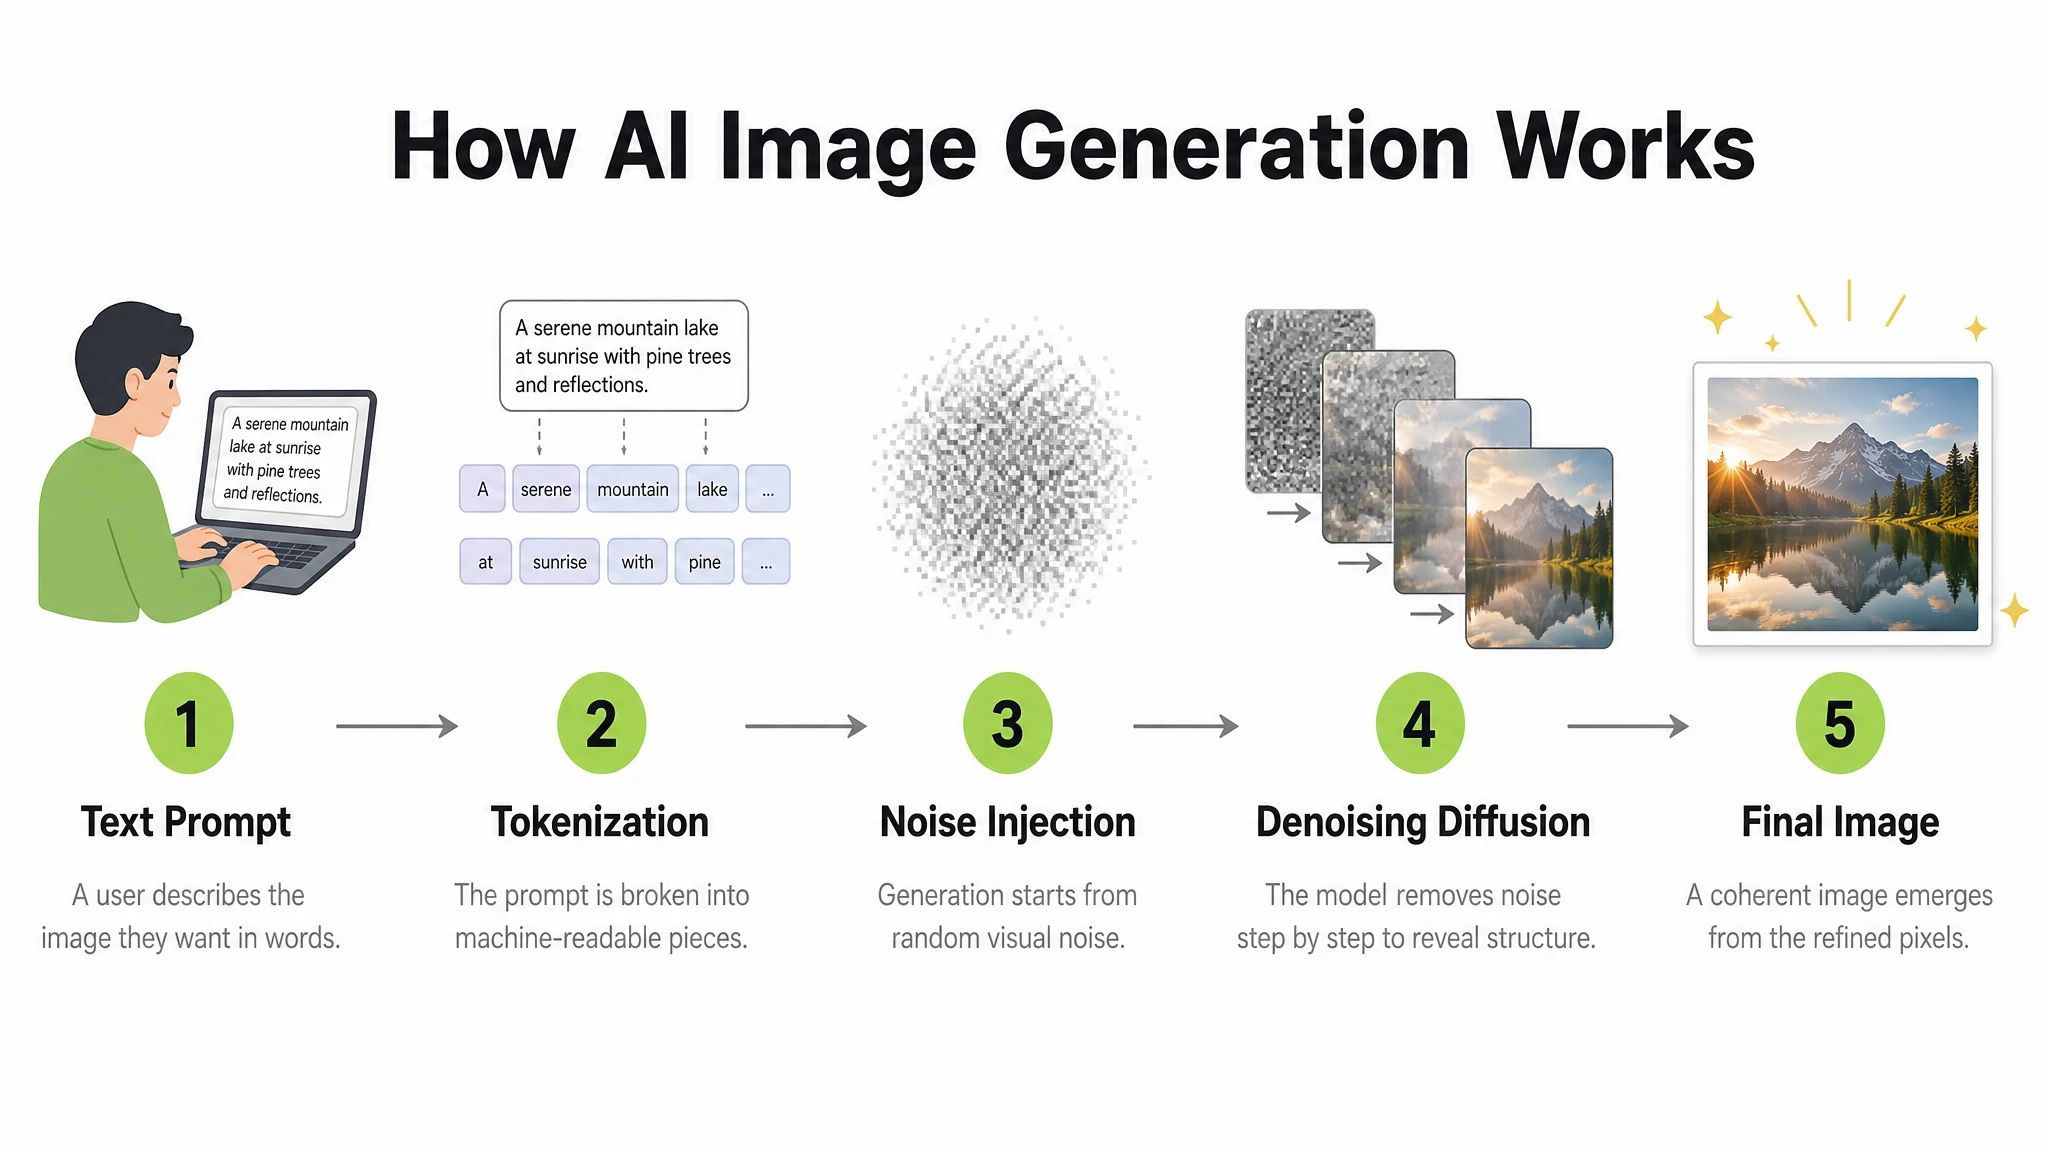
プロンプト
A clean, modern educational infographic titled "How AI Image Generation Works" showing 5 steps in a left-to-right horizontal flow. Step 1: "Text Prompt" — icon of a person typing. Step 2: "Tokenization" — text being split into tokens. Step 3: "Noise Injection" — abstract Gaussian noise cloud. Step 4: "Denoising Diffusion" — blurry image sharpening. Step 5: "Final Image" — glowing completed photograph. Each step has: a bold number in a lime green circle, a simple flat icon above, the step title in bold dark text, and a one-line description in lighter grey below. Steps connected by clean horizontal arrows. White background. Clear typographic hierarchy. No decorative clutter.
7. UIモックアップとアプリインターフェースデザイン
UIモックアップ生成は、GPT Image 2が以前のどのモデルよりも優れて処理する新しいユースケースです。正確なテキストレンダリング、レイアウト推論、アイコンレベルの詳細の組み合わせにより、デザインツールなしで信頼できるアプリ画面やダッシュボードを生成することが可能になります——これは迅速なプロトタイピング、ピッチデッキ、デザインチームが実際に構築する前のステークホルダー調整に役立ちます。
モバイルバンキングアプリダッシュボードをテスト:ナビゲーションラベル、口座残高、取引履歴行、カード要素を含むレイアウトが複雑なプロンプトです。
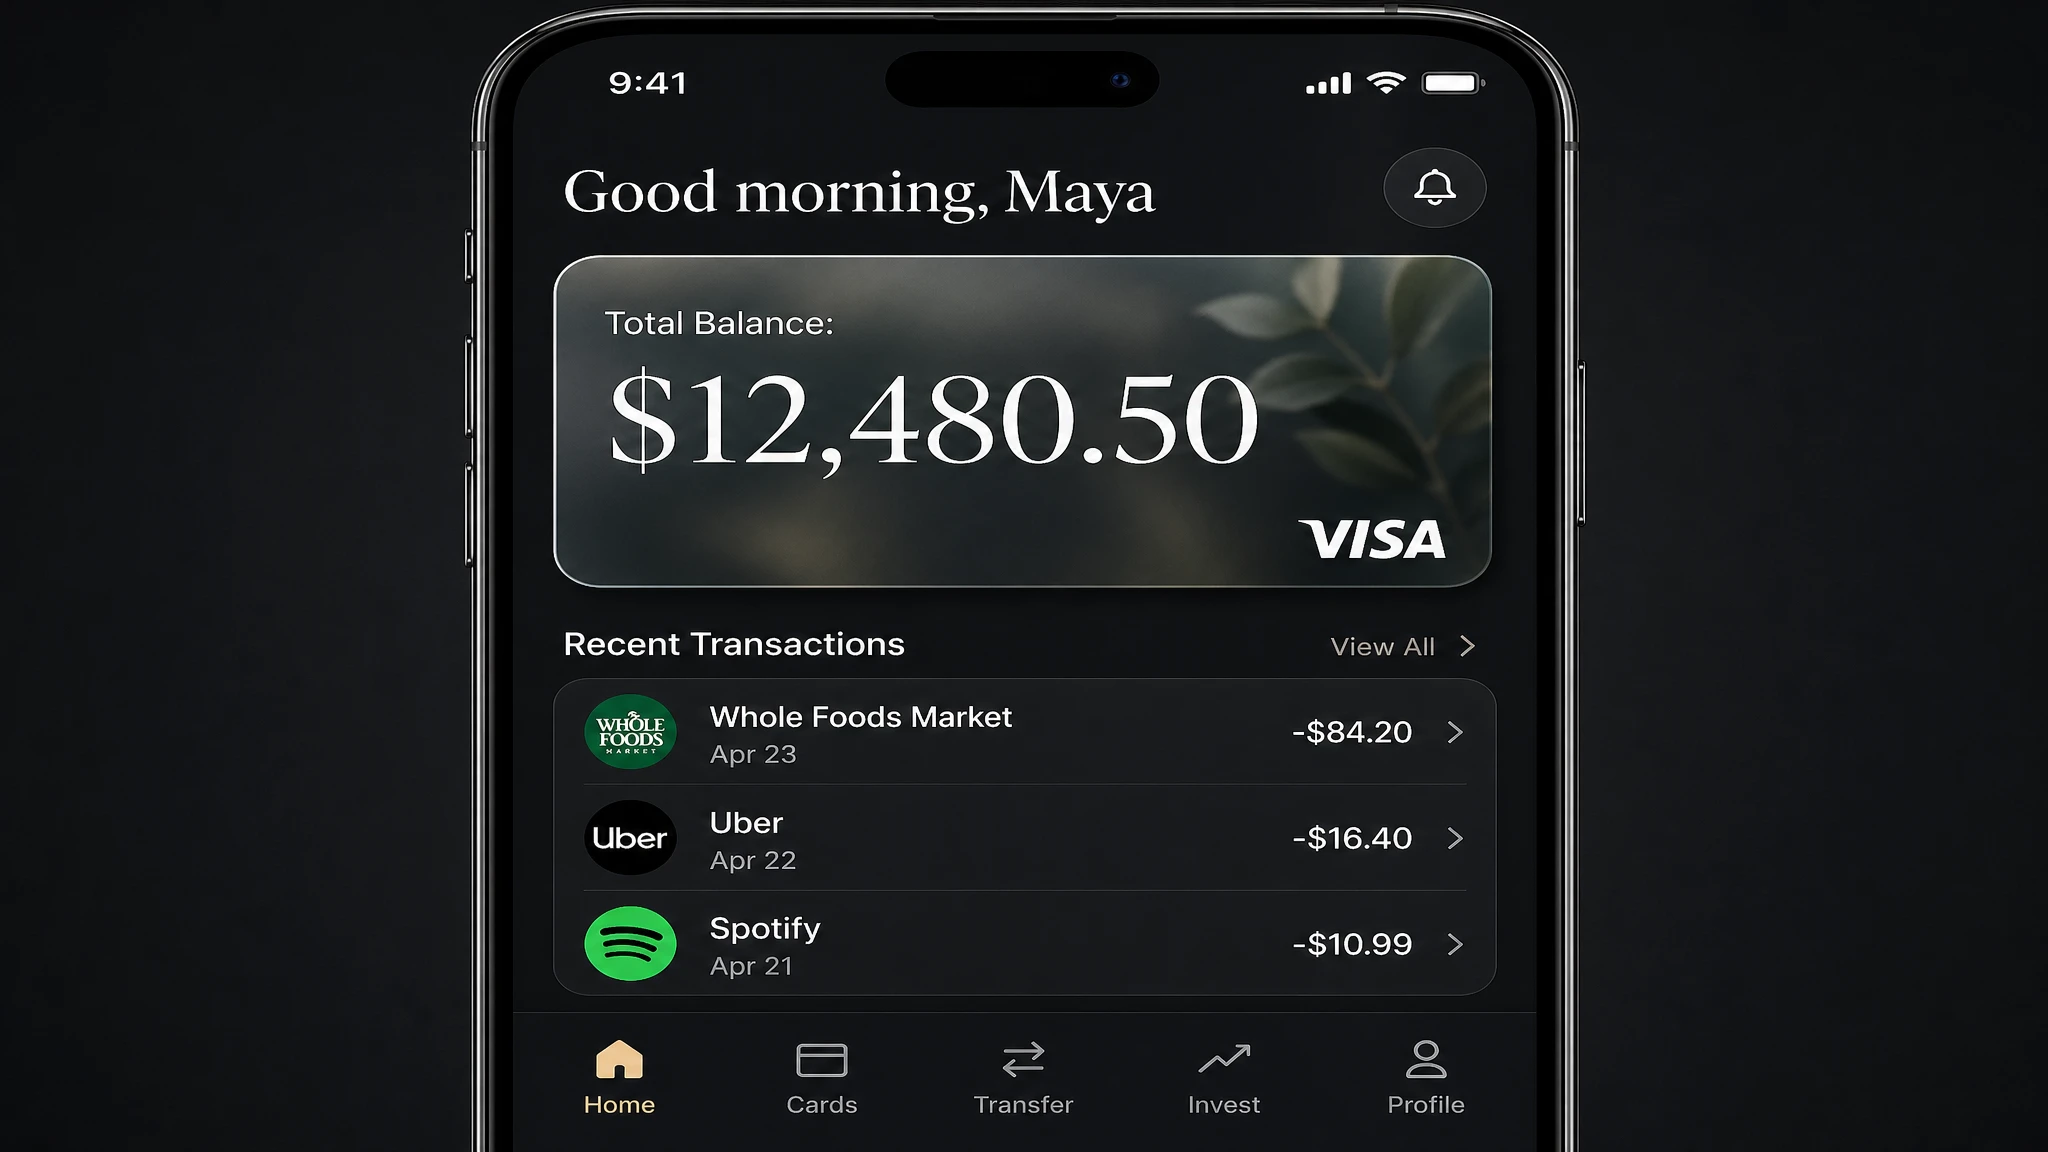
プロンプト
A photorealistic mobile app UI mockup for a premium digital bank. Dark charcoal background. Top section: user greeting "Good morning, Maya" in white. Below: a frosted glass card element showing "Total Balance: $12,480.50" in a large white serif, with a small visa logo in the bottom right. Below the card: a section titled "Recent Transactions" with three rows — each row has a category icon on the left, merchant name and date in the center, and amount on the right (e.g. "Whole Foods Market · Apr 23 · -$84.20"). Bottom navigation bar with five icons: Home, Cards, Transfer, Invest, Profile. All labels must be legible. Clean, minimal, premium fintech aesthetic.
結果:残高の数字、取引行、ナビゲーションラベルがすべて正確にレンダリングされています。磨りガラスのカード要素は正確な半透明感があります。ムードボードまたはステークホルダープロトタイプとして使用可能——本番対応コードではありませんが、Figmaファイルなしにデザイン方向を伝えるには十分です。
8. Thinkingモード:マルチ画像の一貫性
ThinkingモードはGPT Image 2の最も差別化された能力であり、他の現在の画像生成モデルとの最大のギャップです。有効にすると、モデルは生成前にプロンプトについて推論します——複雑さに応じて多かれ少なかれコンピュートを費やし——そしてその推論フェーズ中にWebを検索できます。Thinkingモードがアクティブな場合、1つのプロンプトから最大8枚の一貫した画像を生成でき、すべての出力でキャラクター、オブジェクト、ビジュアルスタイルが維持されます。
これは絵本のイラスト、絵コンテ、シリーズブランドキャンペーン、ゲームコンセプトアートに直接役立ちます。ThinkingモードへのアクセスにはChatGPT Plus、Pro、ビジネス、またはエンタープライズのサブスクリプションが必要です。無料ユーザーは推論ステップなしの標準生成を受け取ります。
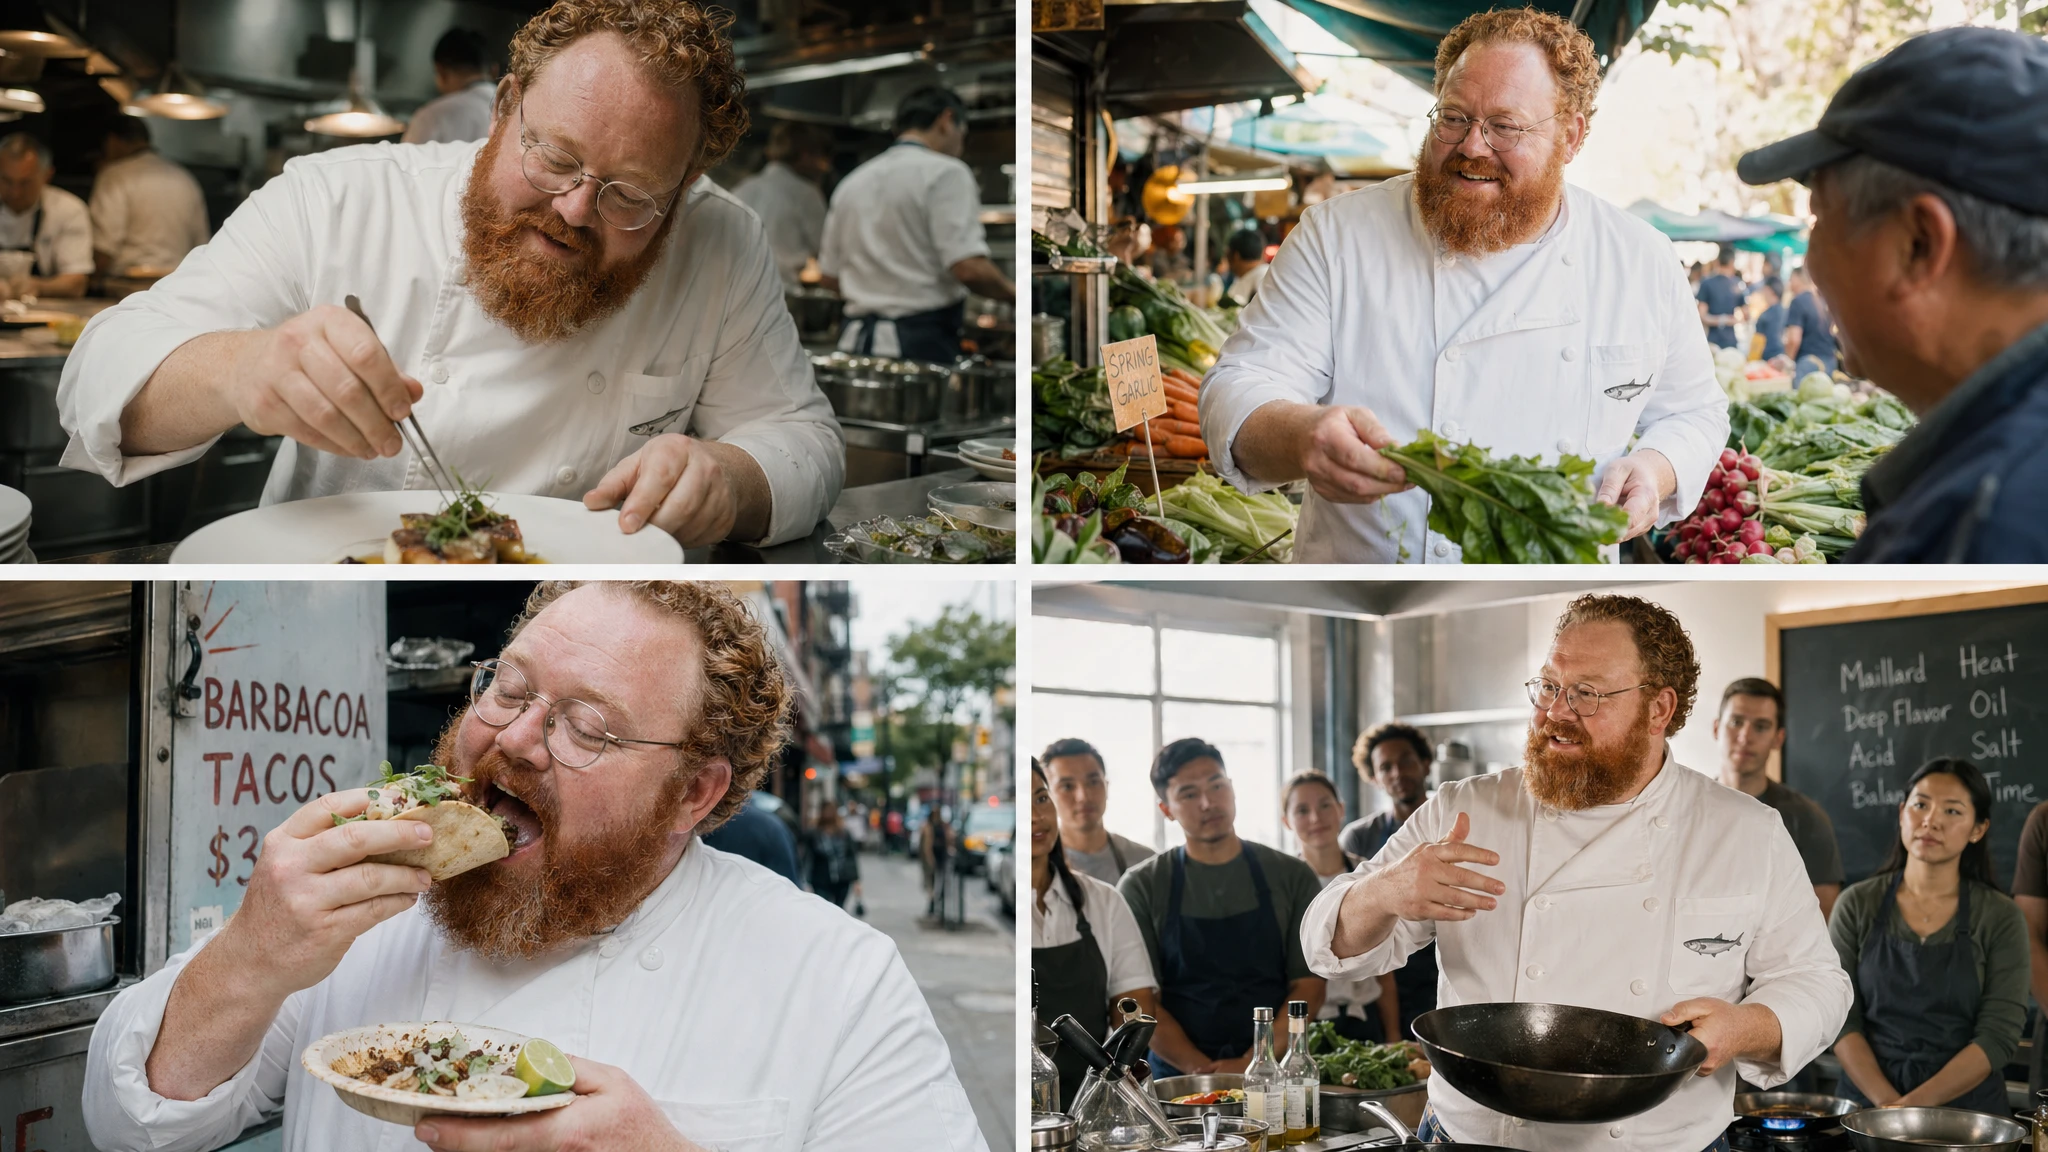
プロンプト
Generate 4 scenes featuring the same character: Chef Milo, a cheerful stocky man in his 40s with a thick red-orange beard, round wire-rimmed glasses, and a white double-breasted chef coat with a small anchovy embroidered on the chest pocket. Scene 1: Milo in a busy open kitchen, plating a dish with tweezers, intense concentration. Scene 2: Milo at a morning market, selecting vegetables, smiling at a vendor. Scene 3: Milo eating a street taco by a food cart, genuine delight on his face. Scene 4: Milo teaching a cooking class, holding a carbon steel wok, students visible in the background. Keep Milo's face, beard, glasses, and coat identical across all four scenes. Cinematic photography style.
これは真に新しいことです:他のどの画像生成APIも1回のAPIコールでキャラクターの継続性を持つマルチ画像バッチ出力を提供していません。連続コンテンツ——絵コンテ、イラスト付きストーリー、マルチシーンキャンペーン——にとって、これは制作の数式を根本的に変えます。
9. 自然言語による画像編集
GPT Image 2は/v1/images/editsエンドポイントを通じて画像編集をサポートします。既存の画像をアップロードし、変更を平易な言葉で説明します。モデルは完全な画像を再生成せずに標的を絞った編集を適用し、指定された要素のみを変更しながらアイデンティティ、構図、照明を保持します。
背景のスワップ、オブジェクトの追加、照明の変更、服の色調整、スタイル転送はすべてテキスト説明だけで機能します。マスクの描画、選択ツール、レイヤー管理は不要です。複数の参照画像を渡して要素を合成することもできます——例えば、ある画像の製品を別の画像のシーンに配置するなど。
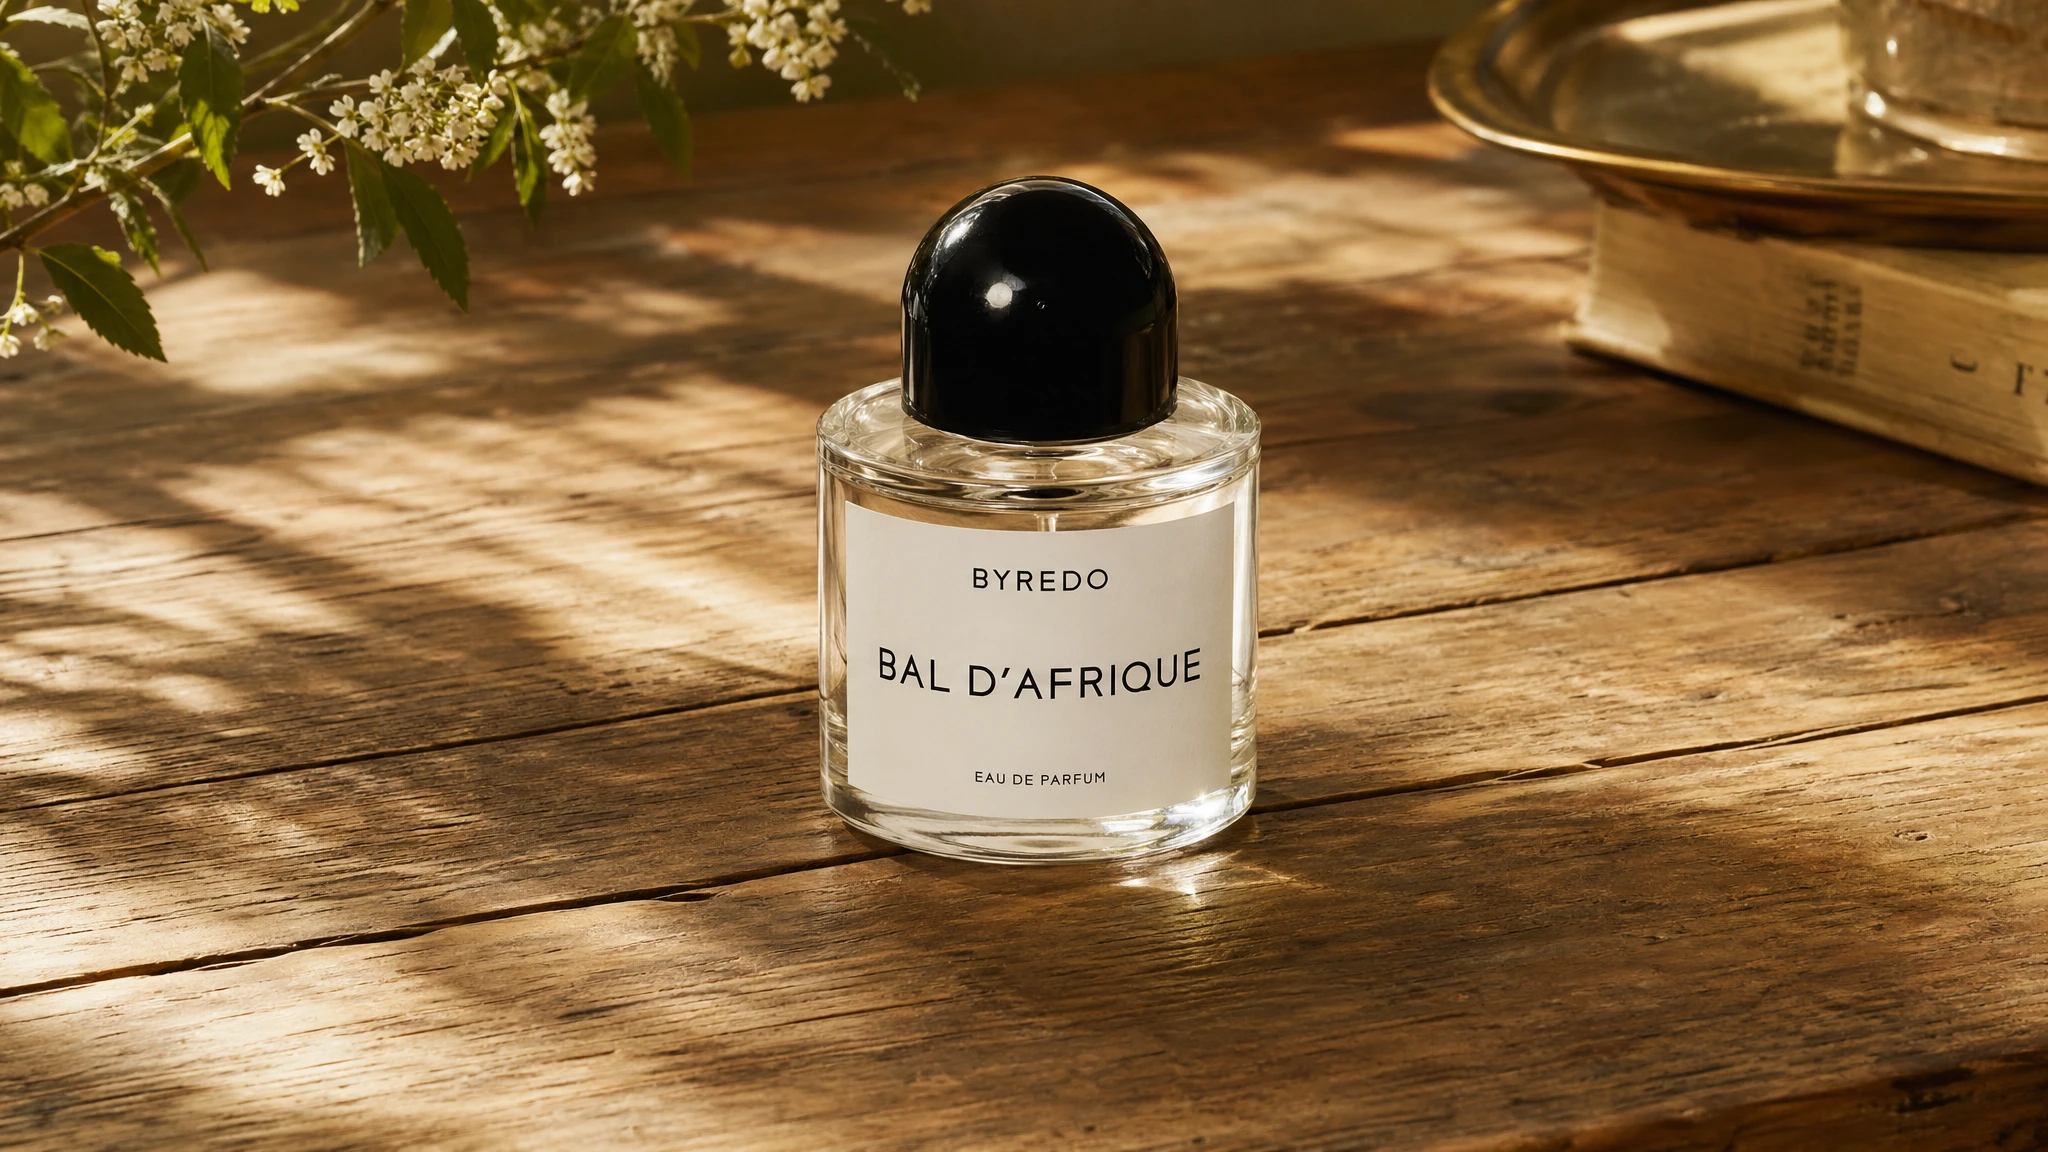
プロンプト
[Edit instruction applied to an existing studio product shot of a glass perfume bottle on white background] Change the background from the plain white studio background to a warm, rustic wooden table surface with soft dappled sunlight coming from the left. Keep the bottle, its reflections, and its shadow exactly as they are. The new background should feel like a high-end lifestyle photograph taken in a sunlit Parisian apartment.
10. 映画的・芸術的スタイルコントロール
GPT Image 2はフォトリアリズムから油絵、水彩、アニメ、ピクセルアート、ハーフトーン印刷、ネオンサイバーパンクまで、50以上の認知された芸術スタイルをカバーします。モデルはプロンプトのスタイル記述に忠実に従い、汎用のAI美学へとドリフトしません——これは以前の世代のモデルの一般的な失敗モードで、指定された具体的なスタイルに関わらず、似たような絵画的な見た目に収束していました。
ハイコントラストの映画的スチールをテスト:特定のジャンル、照明設定、カラーグレードをすべて一緒に指定。
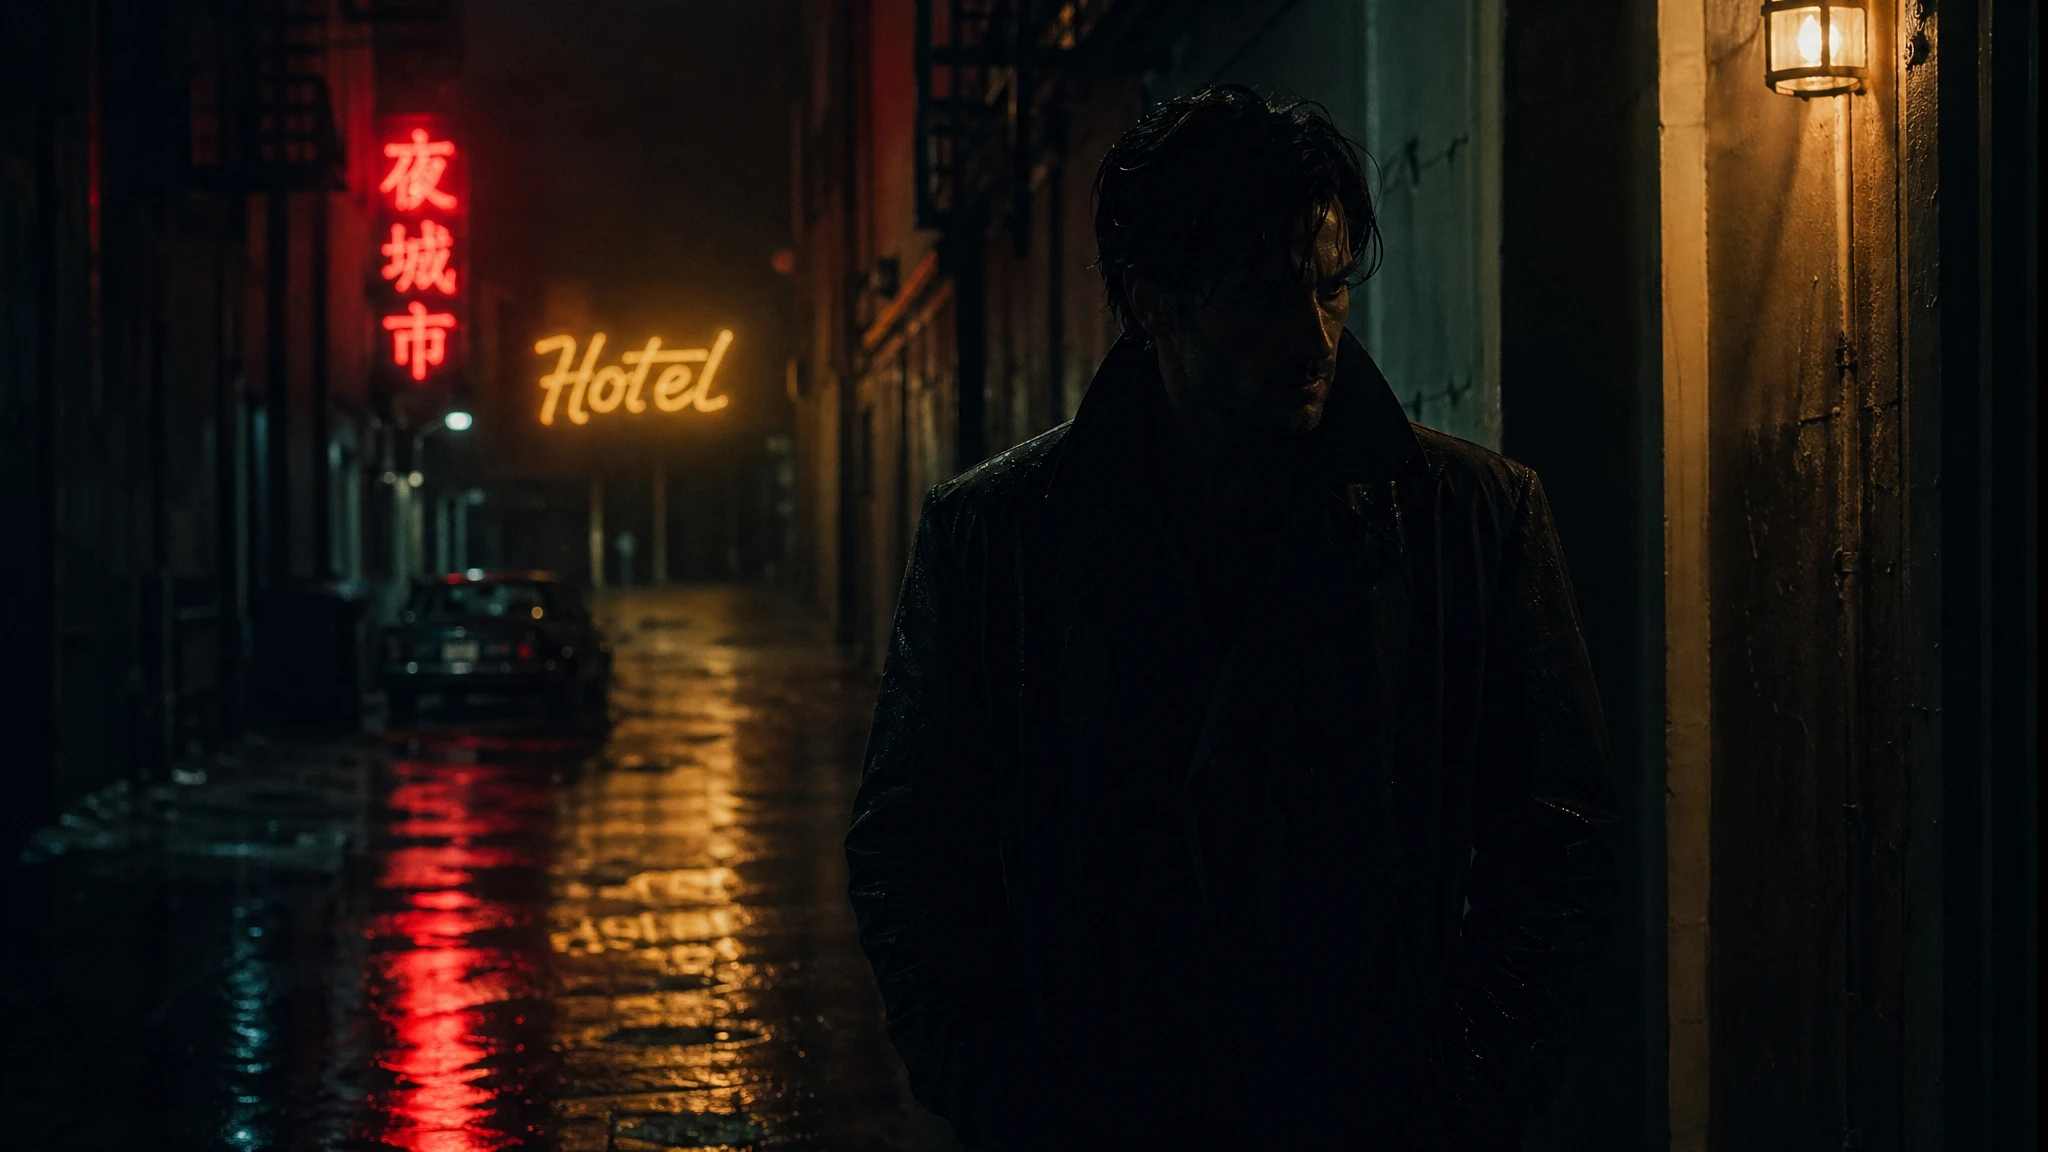
プロンプト
A cinematic still in the style of contemporary neo-noir. A lone figure in a dark trench coat walks down a rain-slicked urban alley at 2am. Reflections of neon signs — one red kanji, one amber "HOTEL" in script — pool on the wet pavement. Shallow depth of field keeps the background signage slightly soft. Color grade: deep teal shadows, warm amber highlights — classic film noir color separation. Low-key side lighting from a practical wall sconce off screen right. The figure's face is partially in shadow. No dialogue. No motion blur. Shot on 35mm Kodak Vision3 500T. Aspect ratio 3:2.
11. ファッション・エディトリアルとライフスタイル写真
ファッションとライフスタイル写真は、GPT Image 2が本番で最も価値の高いカテゴリの1つです。モデルは布地のテクスチャ——リネンの織り、レザーのグレイン、サテンの光沢——をデザインチームにスタイリングの詳細を明確に伝えられる忠実度でレンダリングします。高級ブランドカタログの本番対応アセットにはまだ届かないかもしれませんが。
主要な能力:GPT Image 2は衣服のブランドラベルを正確にレンダリングできます。「ÉLISE PARIS」と読み取れるラベルを指定したプロンプトは、その画像内でラベルが読み取れる衣服を生成します。これはGPT Image 2でのみ可能——以前のモデルはテキストをぐちゃぐちゃにするか省略していました。
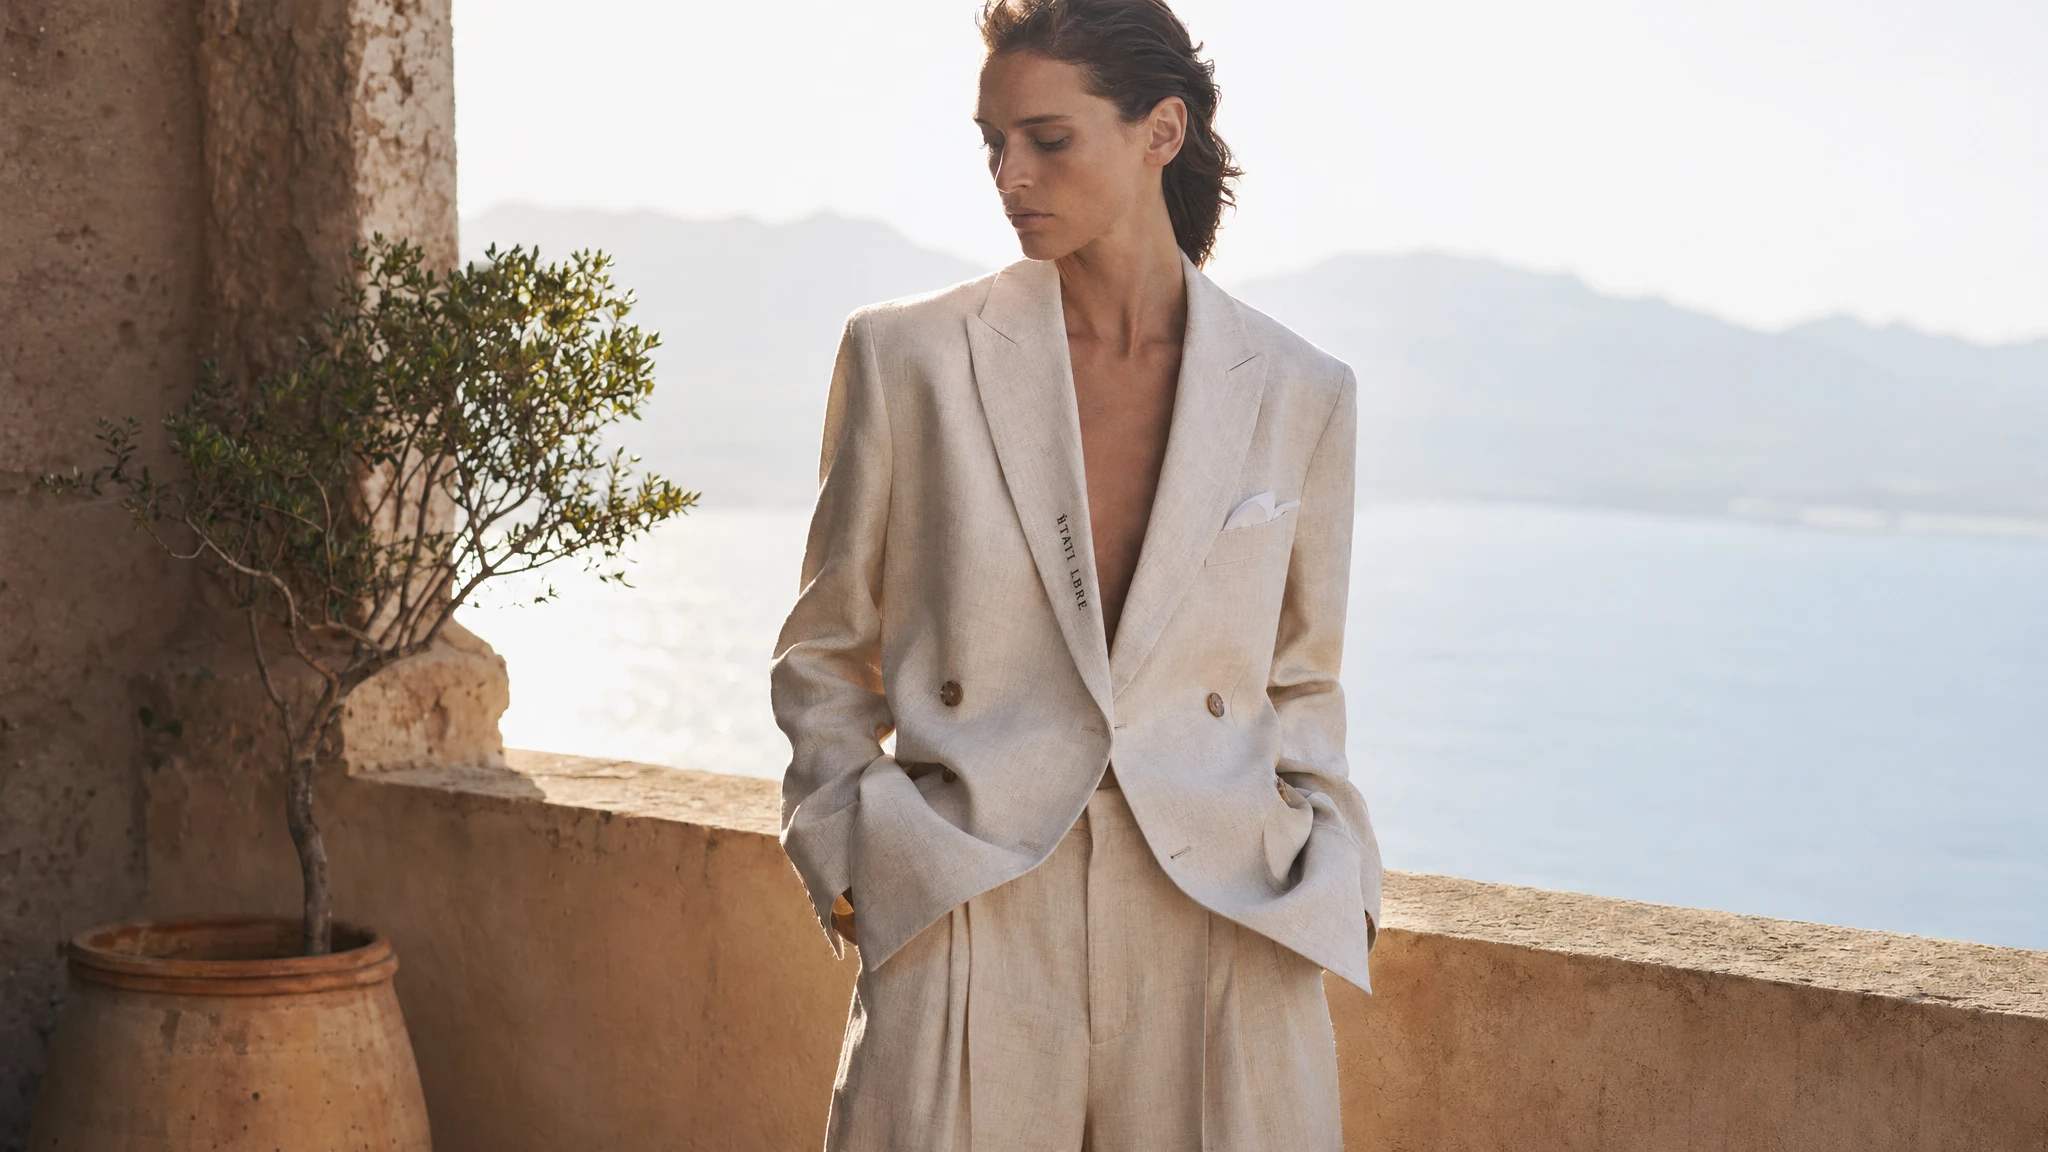
プロンプト
An editorial fashion photograph. Subject: a tall woman in an oversized cream linen suit — wide-leg trousers with sharp creases and a boxy double-breasted blazer. The blazer has a small chest pocket with a folded white pocket square and a brand label visible on the inner lapel reading "ÉTAT LIBRE". She stands on a sun-bleached stone terrace overlooking the Mediterranean Sea, golden hour light behind her creating a natural rim light on her silhouette. Shot on medium format, 80mm equivalent. The linen fabric texture and stitching are clearly visible. Expression: composed, distant, slightly downward gaze.
12. Web検索グラウンディングによるリアルワールドシーンの正確性
Thinkingモードでは、GPT Image 2は生成前にWebを検索できます。これは実在する被写体を参照するプロンプトで最も重要です:特定の建物、ブランドロゴ、文化的ランドマーク、または現在の製品デザイン。トレーニングデータからもっともらしい近似値を生成するのではなく、モデルはライブのWeb画像を検索し、見つけたものを使って生成内容を事実の精度に基づかせます。
GPT Image 2の知識カットオフは2025年12月です。その日以降に変更または登場した被写体——新製品デザイン、2026年のイベント、最近更新されたブランドアイデンティティ——については、ThinkingモードのWeb検索がそのギャップを部分的に埋めます。トレーニングウィンドウ内の被写体については、視覚的精度の改善は実質的です。
特定の芸術スタイルでレンダリングされた実在のランドマークをテストしました——建物の外観の事実的な正確さとスタイルの実行の両方を必要とするプロンプトです。
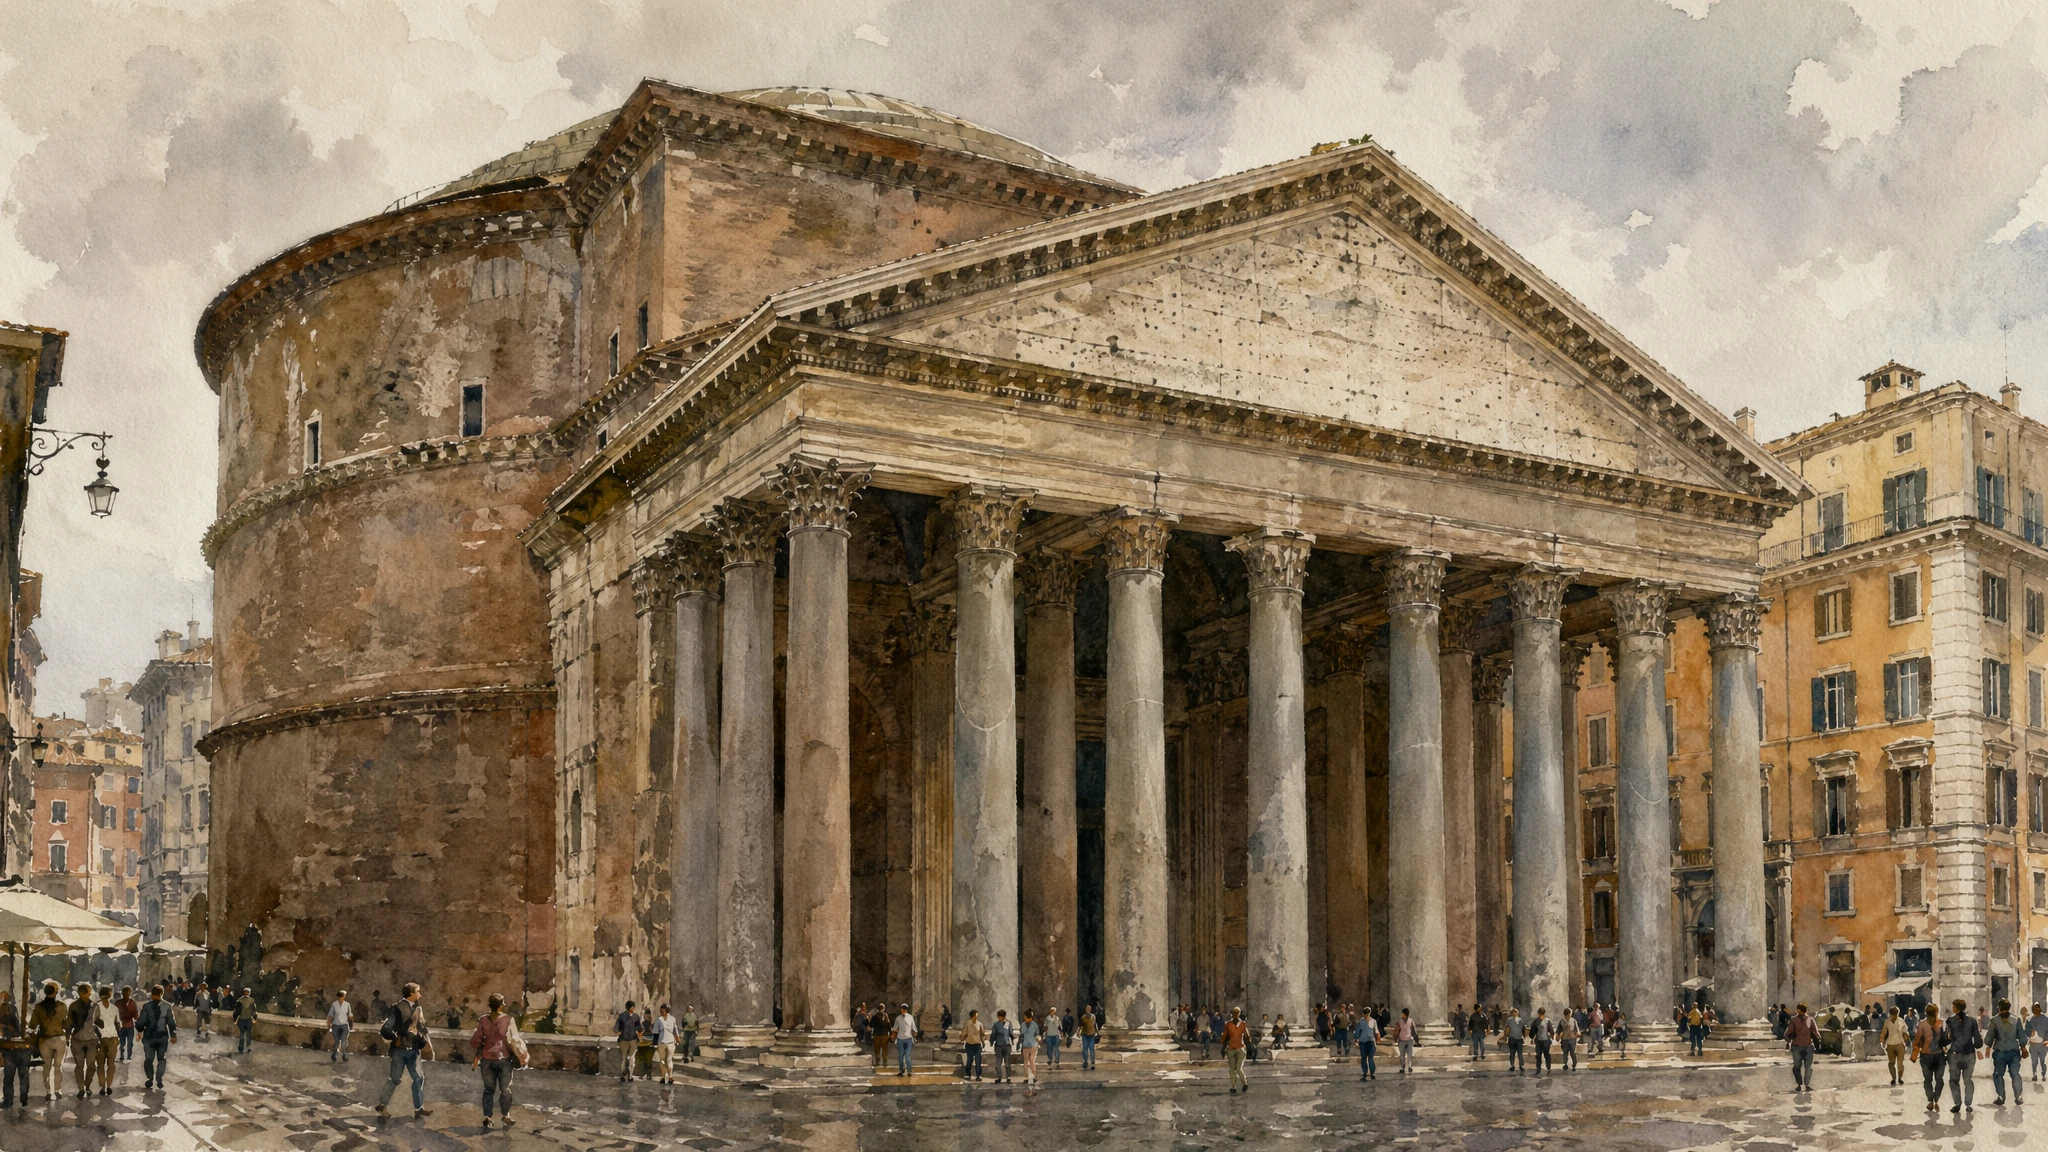
プロンプト
Search the web for visual references of the Pantheon in Rome, then generate an image of it in loose architectural watercolor style. The painting should accurately reflect the real building's proportions: the massive Corinthian portico with sixteen granite columns in three rows, the triangular pediment, and the cylindrical drum behind it. Medium: loose warm-toned watercolor with deliberate wet-on-wet washes, visible paper texture, and dry brush strokes on the column edges. A small crowd of tourists in simple gestural marks at street level. Overcast soft Roman morning light. No text. Aspect ratio 3:2.
結果:生成画像の列数とポルティコの比例は実際のパンテオンと一致しています——16本の柱、正確な三角形のペディメント、ポルティコとロタンダドラム間の正確な深さの関係。Webグラウンディングなしでは、以前のモデルは実際の建物から大きく逸脱した「汎用のローマ神殿」のようなものを生成していました。
既知の制限事項
- 知識カットオフ:2025年12月。その日以降に登場したイベント、製品デザイン、公人は不正確または拒否された出力を生む可能性があります。ThinkingモードのWeb検索がこれを部分的に緩和します。
- 透明背景非対応:gpt-image-2では透明背景は現在サポートされていません。background:"transparent"パラメータは非対応です。他のモデルからPNG出力を使用するか後処理を行ってください。
- 小さなポイントサイズの完全な記号付きアラビア語とヘブライ語:密集した段落では約20文字に1文字のエラーが発生します。基本的なサインと見出しは確実に機能します。
- 非常に小さなポイントサイズの密集した本文(例:5pt相当の新聞本文):段落あたり約95%の精度——ほとんどの用途には十分ですが、タイポグラフィ的に精密なアセットには検証が必要です。
- 複雑なマルチリージョン編集:3つ以上の異なる空間領域にわたる同時変更を必要とする編集は、クリーンな結果を得るために2〜3回の反復が必要な場合があります。
- Thinkingモードのレイテンシ:複雑なマルチ画像生成はバッチあたり最大2分かかる場合があります。リアルタイムまたは5秒以下の応答要件には不適です。
- バースト負荷下でのレート制限:高頻度のAPIバースト負荷はTier 1〜2アカウントのレート制限を引き起こす可能性があります。本番統合では指数バックオフを計画してください。
まとめ:GPT Image 2をいつ使うべきか
| ユースケース | 品質基準 | 使用する主要機能 | 推奨品質設定 |
|---|---|---|---|
| 画像内テキスト付きマーケティング広告 | 本番対応 | テキストレンダリング | 高 |
| 製品写真 | 本番対応 | フォトリアリズム、マテリアルテクスチャ | 高 |
| パッケージモックアップ | ピッチ/プロトタイプ | 3Dサーフェスでのテキストレンダリング | 高 |
| UIモックアップ/アプリプロトタイプ | ステークホルダー調整 | レイアウト推論、テキスト精度 | 中 |
| インフォグラフィック/図解 | 本番対応 | テキスト+レイアウト | 中または高 |
| ポートレート写真 | 本番対応 | アイデンティティセンシティブレンダリング | 高 |
| ファッションエディトリアル | プロトタイプ/キャンペーン | スタイルコントロール、布地テクスチャ | 高 |
| 絵本/絵コンテ | 本番対応 | マルチ画像の一貫性(Thinkingモード) | 中 |
| 実在のランドマークシーン | 正確な表現 | Web検索グラウンディング(Thinkingモード) | 高 |
| ソーシャルメディアサムネイル | 本番対応 | 構図+画像内テキスト | 低または中 |
| コンセプトアート/映画スチール | クリエイティブ探求 | 芸術スタイルコントロール | 中 |
| 高速反復/ドラフトバッチ | 内部レビュー | 速度とコスト | 低 |
GPT Image 2は、テキストレンダリングの精度が要件であるすべてのワークフローに最適な選択肢です——パッケージ、マーケティングクリエイティブ、インフォグラフィック、UIモックアップ、エディトリアルレイアウト。また、1回のAPIコールでキャラクターの継続性を持つマルチ画像バッチ生成を提供する唯一のモデルでもあります。
抽象的な芸術スタイルの探求、最高の速度、または大規模での最低単価を優先するワークフローでは、スタックを確定する前に、実際のプロンプトセットで代替案とGPT Image 2を評価してください。